PLS-SEM (mô hình cấu trúc bình phương tối thiểu từng phần) là lựa chọn phổ biến khi mô hình có nhiều biến tiềm ẩn, cỡ mẫu vừa phải và mục tiêu chính là dự báo. Với SmartPLS 4, bạn có thể đánh giá mô hình đo lường và mô hình cấu trúc chỉ trong vài cửa sổ thao tác. Tuy vậy, chạy được chưa có nghĩa là đọc đúng và báo cáo đúng.
Bài viết hướng dẫn khi nào chọn phương pháp này thay cho CB-SEM, các bước chạy trên SmartPLS 4, bảng ngưỡng theo Hair và cộng sự, ví dụ diễn giải kèm câu viết chuẩn APA, lỗi thường gặp và checklist.
Điểm chính của bài
- PLS-SEM phù hợp với mục tiêu dự báo, mô hình phức tạp, cấu trúc dạng tổng hợp (composite) và dữ liệu không chuẩn.
- Đánh giá theo hai giai đoạn: mô hình đo lường (loading, CR, AVE, HTMT) trước, mô hình cấu trúc (VIF, hệ số đường dẫn, \(R^2\), \(f^2\), \(Q^2\)) sau.
- Kiểm định ý nghĩa bằng Bootstrapping với 5.000 mẫu con, đọc khoảng tin cậy và giá trị \(p\).
- Năng lực dự báo ngoài mẫu đánh giá bằng PLSpredict thay vì chỉ dựa vào \(R^2\).
- Không dùng các chỉ số model fit của CB-SEM như CFI, RMSEA để "chứng minh" mô hình PLS tốt.
Nội dung bài viết
- PLS-SEM là gì và khác CB-SEM ở điểm nào?
- Chuẩn bị dữ liệu và mô hình trước khi chạy
- Các bước chạy PLS-SEM trên SmartPLS 4
- Đánh giá mô hình đo lường trong PLS-SEM
- Đánh giá mô hình cấu trúc PLS-SEM
- Ví dụ diễn giải kết quả PLS-SEM
- Phân tích trung gian và điều tiết trong PLS-SEM
- Lỗi thường gặp khi làm PLS-SEM và cách xử lý
- Checklist hoàn thành PLS-SEM trước khi nộp
- Câu hỏi thường gặp về PLS-SEM
- Tài liệu tham khảo
PLS-SEM là gì và khác CB-SEM ở điểm nào?
Mô hình cấu trúc tuyến tính (SEM) có hai họ phương pháp chính. CB-SEM (dựa trên hiệp phương sai, chạy bằng AMOS, LISREL, Mplus) cố gắng tái tạo ma trận hiệp phương sai quan sát được, vì vậy rất mạnh trong việc kiểm định lý thuyết và đánh giá độ phù hợp tổng thể. Nếu bạn đi theo hướng này, hãy xem bài phân tích SEM trên AMOS.
PLS-SEM lại tối đa hóa phương sai được giải thích của các biến nội sinh. Thuật toán ước lượng điểm số của từng cấu trúc như một tổ hợp có trọng số của các biến quan sát, sau đó chạy chuỗi hồi quy bình phương tối thiểu.
Theo Hair và cộng sự (2019), sự khác biệt không nằm ở việc phương pháp nào "tốt hơn" mà ở mục tiêu nghiên cứu. Nếu câu hỏi là "mô hình lý thuyết có khớp dữ liệu không", CB-SEM thường phù hợp hơn. Nếu câu hỏi là "các yếu tố nào giải thích và dự báo tốt biến kết quả", PLS-SEM là lựa chọn hợp lý.
Khi nào nên chọn PLS-SEM?
Bạn nên cân nhắc PLS-SEM trong các tình huống sau:
- Mục tiêu nghiên cứu mang tính khám phá hoặc dự báo, lý thuyết nền chưa thật vững.
- Mô hình phức tạp: nhiều cấu trúc, nhiều đường dẫn, có biến trung gian và điều tiết cùng lúc.
- Có cấu trúc đo lường dạng nguyên nhân (formative), điều mà CB-SEM xử lý khá khó.
- Cỡ mẫu không lớn hoặc dữ liệu lệch phân phối rõ rệt.
Lưu ý: "Cỡ mẫu nhỏ" không phải là tấm vé miễn kiểm tra. PLS-SEM vẫn cần đủ mẫu để đạt công suất thống kê. Quy tắc "10 lần" chỉ là mức sàn thô; Hair và cộng sự (2022) khuyến nghị phân tích công suất hoặc phương pháp căn bậc hai nghịch đảo. Xem thêm bài cách tính cỡ mẫu.
Chuẩn bị dữ liệu và mô hình trước khi chạy
Trước khi mở SmartPLS, hãy làm sạch dữ liệu: giá trị ngoài miền thang đo, phiếu trả lời một kiểu, dữ liệu thiếu và câu hỏi đảo. Nếu bạn còn lúng túng ở bước này, bài nhập liệu SPSS sẽ giúp bạn chuẩn hóa tên biến.
SmartPLS 4 đọc file .csv, .xlsx và .sav. Dòng đầu là tên biến không dấu (HQ1, HQ2, YD1); giá trị thiếu mã hóa thống nhất, chẳng hạn -99.
Về lý thuyết, bạn cần xác định từ đầu mỗi cấu trúc là dạng phản ánh (reflective) hay dạng nguyên tạo (formative). Thang đo Likert vay mượn từ các nghiên cứu trước thường là dạng phản ánh.
Các bước chạy PLS-SEM trên SmartPLS 4
Quy trình dưới đây áp dụng cho SmartPLS 4 (giao diện năm 2022 trở đi). Tài liệu chính thức có tại trang chủ SmartPLS.
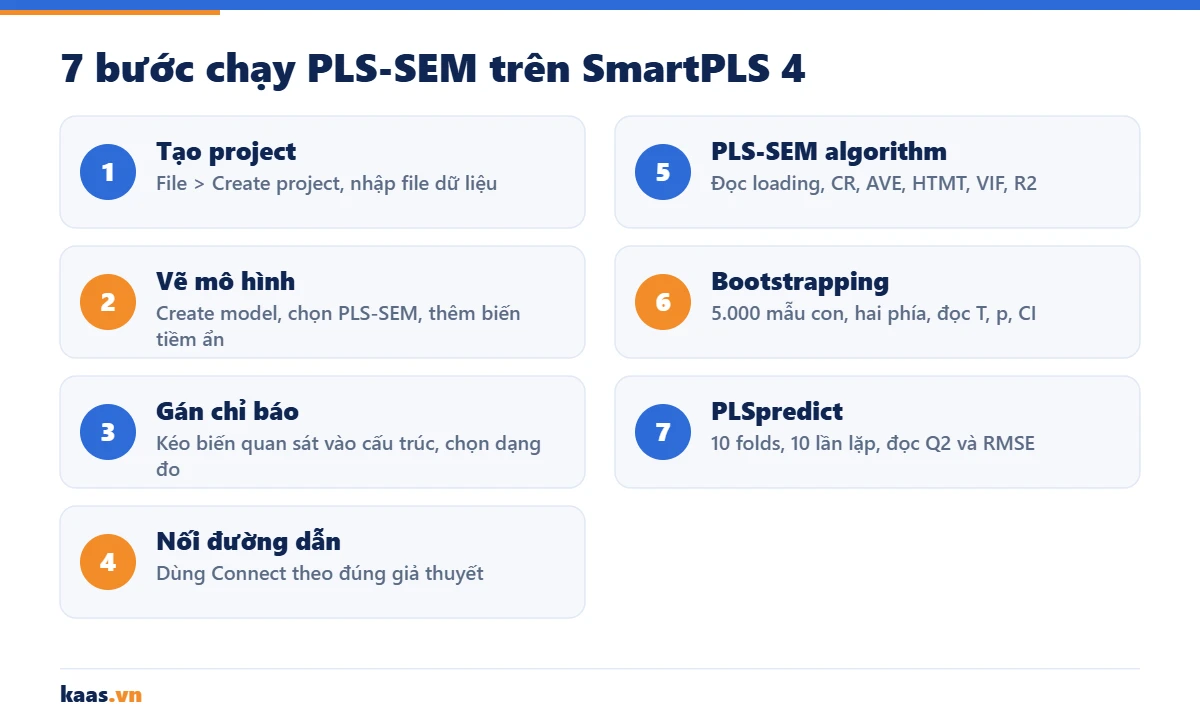
- Tạo project và nhập dữ liệu. Chọn File > Create project, đặt tên, sau đó Import data file và trỏ tới file dữ liệu.
- Tạo mô hình. Nhấp Create model, chọn loại PLS-SEM. Trên thanh công cụ chọn Latent variable, vẽ các hình tròn và đặt tên cấu trúc.
- Gán biến quan sát. Kéo các chỉ báo từ bảng Indicators thả vào từng cấu trúc. Mặc định là dạng phản ánh; nhấp chuột phải và chọn Switch between formative/reflective nếu cần.
- Vẽ đường dẫn. Dùng công cụ Connect nối các cấu trúc theo giả thuyết.
- Chạy thuật toán. Chọn Calculate > PLS-SEM algorithm, giữ thiết lập mặc định (Path weighting scheme, tối đa 3.000 vòng lặp, tiêu chí dừng \(10^{-7}\)). Kiểm tra mô hình hội tụ trước khi đọc số.
- Chạy Bootstrapping. Chọn Calculate > Bootstrapping, đặt Subsamples = 5.000, kiểm định hai phía (Two tailed), mức ý nghĩa 0,05, khoảng tin cậy Percentile bootstrap.
- Chạy PLSpredict. Chọn Calculate > PLSpredict, đặt Number of folds = 10, Number of repetitions = 10 để đánh giá năng lực dự báo ngoài mẫu.
Mẹo: Đặt seed cố định trong phần thiết lập nâng cao của Bootstrapping để người khác chạy lại cho ra đúng cùng kết quả. Ghi seed vào phụ lục luận văn.
Đánh giá mô hình đo lường trong PLS-SEM
Giai đoạn đầu kiểm tra xem các thang đo có đo đúng và đo ổn định hay không. Với cấu trúc dạng phản ánh, bạn đọc kết quả trong báo cáo của PLS-SEM algorithm theo bốn nhóm tiêu chí.
Độ tin cậy chỉ báo và độ tin cậy nhất quán nội bộ
Hệ số tải ngoài (Outer loadings) nên từ 0,708 trở lên, vì khi đó cấu trúc giải thích hơn 50% phương sai của chỉ báo. Chỉ báo có tải từ 0,40 đến 0,70 chỉ nên loại khi việc loại giúp CR hoặc AVE vượt ngưỡng và không làm mất ý nghĩa nội dung.
Độ tin cậy nhất quán nội bộ đọc qua Cronbach's alpha, rho_A và độ tin cậy tổng hợp rho_C (CR). Mức từ 0,70 đến 0,90 là tốt; 0,60 đến 0,70 chấp nhận được trong nghiên cứu khám phá; trên 0,95 là dấu hiệu các câu hỏi trùng lặp. Nếu bạn muốn ôn lại alpha, xem bài Cronbach's alpha trong SPSS.
Giá trị hội tụ và giá trị phân biệt
Giá trị hội tụ đánh giá bằng phương sai trích trung bình (AVE) theo Fornell và Larcker (1981), yêu cầu AVE từ 0,50 trở lên.
Giá trị phân biệt hiện nay ưu tiên chỉ số HTMT của Henseler và cộng sự (2015). HTMT nên nhỏ hơn 0,85 với các cấu trúc khác biệt rõ về khái niệm, và nhỏ hơn 0,90 với các cấu trúc gần nhau về khái niệm. Có thể bổ sung khoảng tin cậy bootstrap của HTMT, yêu cầu cận trên nhỏ hơn ngưỡng đã chọn. Chi tiết có trong bài HTMT và giá trị phân biệt.
| Tiêu chí | Chỉ số | Ngưỡng khuyến nghị | Nguồn |
|---|---|---|---|
| Độ tin cậy chỉ báo | Outer loading | \(\geq 0{,}708\) | Hair và cộng sự (2019) |
| Nhất quán nội bộ | Cronbach's alpha, rho_A, rho_C | 0,70 - 0,90 (không quá 0,95) | Hair và cộng sự (2022) |
| Giá trị hội tụ | AVE | \(\geq 0{,}50\) | Fornell và Larcker (1981) |
| Giá trị phân biệt | HTMT | < 0,85 (khái niệm khác xa) hoặc < 0,90 (khái niệm gần) | Henseler và cộng sự (2015) |
| Formative: đa cộng tuyến | Outer VIF | Lý tưởng < 3, tối đa < 5 | Hair và cộng sự (2022) |
| Formative: ý nghĩa trọng số | Outer weights (bootstrap) | \(p < 0{,}05\), nếu không thì xét loading \(\geq 0{,}50\) | Hair và cộng sự (2022) |
Với cấu trúc dạng nguyên tạo, không dùng alpha hay AVE mà kiểm tra phân tích dư thừa (redundancy analysis), VIF của chỉ báo và ý nghĩa trọng số ngoài.
Đánh giá mô hình cấu trúc PLS-SEM
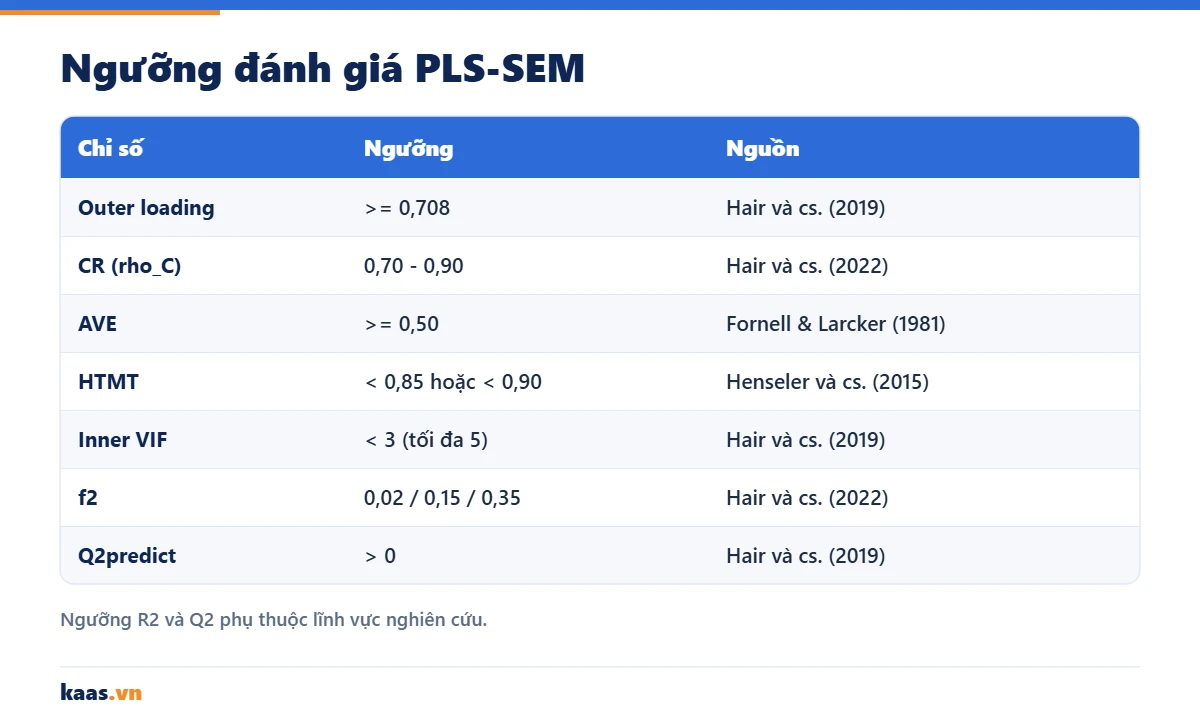
Khi mô hình đo lường đạt yêu cầu, bạn chuyển sang mô hình cấu trúc. Thứ tự hợp lý gồm năm bước: đa cộng tuyến, ý nghĩa và độ lớn hệ số đường dẫn, hệ số xác định, quy mô ảnh hưởng và năng lực dự báo.
Đa cộng tuyến và hệ số đường dẫn trong PLS-SEM
Mở mục Collinearity statistics (VIF) > Inner model. Giá trị VIF dưới 3 là lý tưởng; từ 3 đến 5 cần thận trọng; từ 5 trở lên là có vấn đề. Xem thêm bài đa cộng tuyến.
Hệ số đường dẫn chuẩn hóa \(\beta\) nằm trong khoảng -1 đến +1. Ý nghĩa thống kê đọc trong báo cáo Bootstrapping, mục Path coefficients: cột Original sample (O), Sample mean (M), Standard deviation (STDEV), T statistics và P values. Giả thuyết được ủng hộ khi \(p < 0{,}05\) và khoảng tin cậy 95% không chứa 0.
Hệ số xác định, quy mô ảnh hưởng và năng lực dự báo
\(R^2\) cho biết tỷ lệ phương sai của biến nội sinh được giải thích. Các mức 0,25; 0,50 và 0,75 thường được xem là yếu, trung bình và mạnh, tùy lĩnh vực. Quy mô ảnh hưởng \(f^2\) đo mức giảm \(R^2\) khi bỏ một biến ngoại sinh:
Các mức 0,02; 0,15 và 0,35 tương ứng ảnh hưởng nhỏ, trung bình và lớn. Cuối cùng, PLSpredict cho \(Q^2_{predict}\): giá trị lớn hơn 0 nghĩa là mô hình dự báo tốt hơn giá trị trung bình đơn thuần. So sánh thêm RMSE (hoặc MAE) của mô hình PLS với mô hình hồi quy tuyến tính chuẩn (LM) cho từng chỉ báo của biến mục tiêu để kết luận mức độ dự báo cao, trung bình hay thấp.
| Chỉ số | Ngưỡng | Cách diễn giải |
|---|---|---|
| Inner VIF | < 3 lý tưởng; < 5 chấp nhận | Không có đa cộng tuyến nghiêm trọng |
| Path coefficient | \(p < 0{,}05\), CI 95% không chứa 0 | Giả thuyết được ủng hộ |
| \(R^2\) | 0,25 / 0,50 / 0,75 | Yếu / trung bình / mạnh (tùy lĩnh vực) |
| \(f^2\) | 0,02 / 0,15 / 0,35 | Nhỏ / trung bình / lớn |
| \(Q^2_{predict}\) | > 0 | Có năng lực dự báo ngoài mẫu |
| RMSE PLS so với LM | Đa số chỉ báo thấp hơn LM | Năng lực dự báo trung bình đến cao |
Ví dụ diễn giải kết quả PLS-SEM
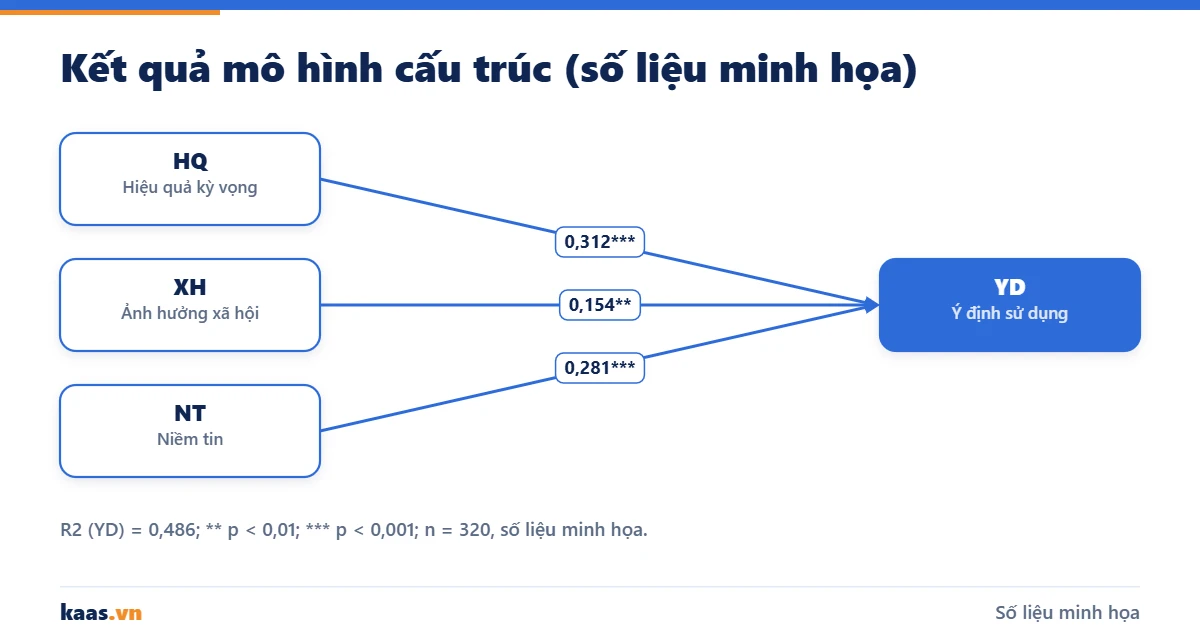
Ví dụ: Một nghiên cứu về ý định sử dụng ví điện tử của sinh viên, cỡ mẫu 320 phiếu hợp lệ (số liệu minh họa). Ba biến độc lập: Hiệu quả kỳ vọng (HQ), Ảnh hưởng xã hội (XH), Niềm tin (NT); biến phụ thuộc: Ý định sử dụng (YD). Mỗi cấu trúc có 4 chỉ báo Likert 5 mức.
Mô hình đo lường của PLS-SEM trong ví dụ (số liệu minh họa): tất cả outer loading nằm trong khoảng 0,742 đến 0,889; rho_C từ 0,861 đến 0,912; AVE từ 0,608 đến 0,722. HTMT cao nhất là 0,71 (giữa HQ và YD), thấp hơn ngưỡng 0,85. Như vậy thang đo đạt độ tin cậy, giá trị hội tụ và giá trị phân biệt.
Mô hình cấu trúc (số liệu minh họa, Bootstrapping 5.000 mẫu con): inner VIF từ 1,42 đến 1,87. Ba đường dẫn đều dương và có ý nghĩa. \(R^2\) của YD là 0,486, tức ba yếu tố giải thích khoảng 48,6% biến thiên của ý định sử dụng.
| Giả thuyết | \(\beta\) | T | p | CI 95% | \(f^2\) | Kết luận |
|---|---|---|---|---|---|---|
| H1: HQ → YD | 0,312 | 5,21 | < 0,001 | [0,195; 0,427] | 0,131 | Ủng hộ |
| H2: XH → YD | 0,154 | 2,63 | 0,009 | [0,041; 0,268] | 0,036 | Ủng hộ |
| H3: NT → YD | 0,281 | 4,47 | < 0,001 | [0,158; 0,402] | 0,104 | Ủng hộ |
PLSpredict cho \(Q^2_{predict}\) của bốn chỉ báo YD từ 0,312 đến 0,398, đều lớn hơn 0; ba trên bốn chỉ báo có RMSE của mô hình PLS thấp hơn LM, tức năng lực dự báo ở mức trung bình (số liệu minh họa).
Cách viết kết quả PLS-SEM theo chuẩn APA
Một đoạn báo cáo mẫu cho luận văn: "Mô hình cấu trúc được ước lượng bằng PLS-SEM trên SmartPLS 4, ý nghĩa thống kê kiểm định bằng bootstrapping với 5.000 mẫu con. Hiệu quả kỳ vọng có tác động dương đến ý định sử dụng (\(\beta = 0{,}312\), \(t = 5{,}21\), \(p < 0{,}001\), 95% CI [0,195; 0,427], \(f^2 = 0{,}131\)). Ba yếu tố giải thích 48,6% phương sai của ý định sử dụng (\(R^2 = 0{,}486\))."
Thứ tự trình bày nên là: mô hình đo lường, HTMT, VIF, kiểm định giả thuyết, rồi \(R^2\), \(f^2\) và PLSpredict, bám sát hướng dẫn của Hair và cộng sự (2019).
Phân tích trung gian và điều tiết trong PLS-SEM
Hiệu ứng gián tiếp đọc trong báo cáo Bootstrapping, mục Specific indirect effects. Tiêu chí kết luận là khoảng tin cậy bootstrap của tích \(a \times b\) không chứa 0, không còn dựa vào kiểm định Sobel. Phân loại trung gian toàn phần hay một phần dựa trên ý nghĩa của hiệu ứng trực tiếp; xem bài phân tích biến trung gian.
Với điều tiết, SmartPLS 4 cho phép thêm hiệu ứng tương tác bằng cách nhấp chuột phải vào biến phụ thuộc, chọn Add moderating effect, phương pháp mặc định là Two-stage. Sau đó dùng biểu đồ Simple slope analysis để diễn giải. Nếu bạn thích làm trên SPSS, bài PROCESS Macro của Hayes là cách thay thế thông dụng; còn khái niệm nền xem ở bài biến điều tiết.
Lỗi thường gặp khi làm PLS-SEM và cách xử lý
- Dùng SRMR, NFI như bằng chứng mô hình "phù hợp". SmartPLS có báo cáo SRMR nhưng Hair và cộng sự (2019) lưu ý các chỉ số fit trong PLS-SEM còn đang phát triển, không nên làm tiêu chí chính.
- Loại chỉ báo hàng loạt chỉ để tăng AVE. Mỗi lần loại cần lý do nội dung và phải được báo cáo.
- Chạy bootstrapping với 500 mẫu con. Con số này quá ít cho báo cáo cuối cùng; dùng tối thiểu 5.000 để kết quả ổn định.
- Áp tiêu chí phản ánh cho cấu trúc nguyên tạo. Alpha thấp ở cấu trúc formative là bình thường, không phải lỗi.
- Bỏ qua sai lệch phương pháp chung. Khi mọi biến đến từ cùng một bảng hỏi tự báo cáo, cần kiểm tra full collinearity VIF; xem bài Common Method Bias.
Lưu ý: Không chỉnh sửa dữ liệu thô để "đẹp" kết quả. Nếu mô hình chưa đạt, hãy xem lại lý thuyết, thang đo hoặc báo cáo trung thực giới hạn nghiên cứu.
Checklist hoàn thành PLS-SEM trước khi nộp
- Đã nêu lý do chọn PLS-SEM gắn với mục tiêu nghiên cứu.
- Đã xác định rõ dạng reflective hoặc formative cho từng cấu trúc.
- Bảng mô hình đo lường có loading, alpha, rho_A, rho_C, AVE.
- Bảng HTMT kèm ngưỡng sử dụng (0,85 hoặc 0,90).
- Bảng inner VIF, hệ số đường dẫn, T, p, khoảng tin cậy, \(f^2\).
- Đã báo cáo \(R^2\) và kết quả PLSpredict (\(Q^2_{predict}\), RMSE so với LM).
- Đã ghi thiết lập Bootstrapping: 5.000 mẫu con, hai phía, loại khoảng tin cậy, seed.
Câu hỏi thường gặp về PLS-SEM
PLS-SEM cần cỡ mẫu tối thiểu bao nhiêu?
Không có con số cố định. Quy tắc 10 lần chỉ là mức sàn thô. Nên dùng phân tích công suất (ví dụ G*Power cho hồi quy với số biến dự báo lớn nhất trỏ vào một cấu trúc) hoặc phương pháp căn bậc hai nghịch đảo theo Hair và cộng sự (2022).
Có cần kiểm tra phân phối chuẩn khi dùng PLS-SEM không?
Phương pháp không yêu cầu phân phối chuẩn, nhưng vẫn nên báo cáo độ lệch và độ nhọn vì dữ liệu lệch mạnh làm sai số chuẩn bootstrap phình to.
Nên dùng HTMT 0,85 hay 0,90?
Dùng 0,85 khi các cấu trúc khác biệt rõ về khái niệm, 0,90 khi chúng gần nhau (ví dụ hài lòng và lòng trung thành). Hãy nêu ngưỡng và lý do ngay trong luận văn.
PLS-SEM có báo cáo model fit không?
SmartPLS 4 có SRMR, d_ULS, d_G, NFI nhưng các chỉ số này chưa được thống nhất ngưỡng trong PLS-SEM. Có thể báo cáo SRMR (dưới 0,08) như thông tin bổ sung, không dùng làm tiêu chí quyết định.
Nên chọn PLS-SEM hay CB-SEM cho luận văn thạc sĩ?
Chọn theo mục tiêu nghiên cứu, không theo phương pháp nào "dễ ra kết quả". Kiểm định lý thuyết vững với mẫu lớn thường ưu tiên CB-SEM.
Cần người đồng hành khi chạy SmartPLS?
Kaas.vn hướng dẫn từng bước qua dịch vụ hỗ trợ SmartPLS, giải thích ý nghĩa từng bảng và bàn giao file project để bạn tự chạy lại; bạn cũng có thể luyện tập với bộ dữ liệu thực hành. Chúng tôi không viết thay và không chỉnh số liệu.
Tài liệu tham khảo
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39-50. doi:10.2307/3151312
- Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). Sage.
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2-24. doi:10.1108/EBR-11-2018-0203
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115-135. doi:10.1007/s11747-014-0403-8
Gửi mô hình (ảnh, Word, PDF) và chọn SPSS, AMOS, SmartPLS, Stata, Eviews hoặc R. Kaas.vn đề xuất phương án và báo giá miễn phí.
- Dịch vụ phân tích dữ liệu nghiên cứu: quy trình 6 bước minh bạch, tái lập được
- Đa cộng tuyến: 3 chỉ số phát hiện và cách xử lý trên SPSS, Stata
- Kiểm định Hausman: 5 bước chọn FEM hay REM cho dữ liệu bảng trên Stata
- ANOVA SPSS: 7 bước chạy One-way ANOVA, Welch, Post Hoc và cách đọc kết quả
- RStudio cho người mới: 6 bước phân tích dữ liệu và phân tích tự động với R
Bài viết cùng chủ đề:
-

Dữ liệu World Bank: 3 cách tải WDI, WGI và xử lý trên Stata
-
Chương 4 luận văn: 7 mục trình bày kết quả nghiên cứu định lượng
-
Common Method Bias: 5 cách phòng ngừa và kiểm định trên SPSS, AMOS
-
Dịch vụ phân tích dữ liệu nghiên cứu: quy trình 6 bước minh bạch, tái lập được
-
HTMT: 5 bước đánh giá giá trị phân biệt trên SmartPLS và AMOS
-
Thiết kế bảng hỏi khảo sát: 8 bước chuẩn học thuật và ví dụ chi tiết
-
Cách tính cỡ mẫu nghiên cứu: 6 công thức thông dụng và ví dụ chi tiết
-

Trắc lượng thư mục với VOSviewer: 7 bước từ tìm kiếm đến bản đồ tri thức
-

RStudio cho người mới: 6 bước phân tích dữ liệu và phân tích tự động với R
-

Phân tích định lượng là gì? 9 phương pháp phổ biến và cách chọn đúng
-

Dịch vụ chạy định lượng tại Kaas.vn: 6 bước minh bạch, chuẩn học thuật
-
Dịch vụ xử lý định lượng: 8 nội dung phân tích SPSS, AMOS, SmartPLS, Stata, Eviews, R
-
Dịch vụ khảo sát nghiên cứu: 7 bước thu thập dữ liệu thật, minh bạch
-

Hỗ trợ chạy Stata: 6 bước phân tích dữ liệu bảng, hồi quy và kiểm định
-
Phân tích SmartPLS 4: 8 bước PLS-SEM từ mô hình đo lường đến trung gian, điều tiết
-

Phân tích độ tin cậy Cronbach's Alpha trong SPSS