Phân tích SEM (mô hình cấu trúc tuyến tính) là kỹ thuật cho phép bạn kiểm định đồng thời nhiều mối quan hệ nhân quả giữa các khái niệm tiềm ẩn, đồng thời tính đến sai số đo lường của từng biến quan sát. Trên AMOS, toàn bộ quy trình phân tích SEM được thực hiện trực quan bằng sơ đồ đường dẫn, nên rất phù hợp với luận văn thạc sĩ và luận án ngành kinh tế, quản trị, giáo dục.
Bài viết hướng dẫn quy trình phân tích SEM từ dữ liệu đã làm sạch đến bảng kết quả hoàn chỉnh: kiểm tra mô hình đo lường bằng CFA, vẽ mô hình cấu trúc, chạy ước lượng, đọc trọng số hồi quy chuẩn hóa, \(R^2\), kiểm định tác động gián tiếp bằng bootstrap, đánh giá độ phù hợp và chỉnh sửa mô hình có cơ sở lý thuyết. Mọi con số trong bài là số liệu minh họa.
Điểm chính của bài
- Phân tích SEM nên đi theo hai bước: kiểm định mô hình đo lường (CFA) trước, mô hình cấu trúc sau (Anderson & Gerbing, 1988).
- Đọc bảng Standardized Regression Weights để so sánh mức tác động, bảng Regression Weights để lấy giá trị p.
- Tác động gián tiếp phải kiểm định bằng bootstrap với khoảng tin cậy hiệu chỉnh độ chệch (bias-corrected).
- Độ phù hợp của phân tích SEM đánh giá bằng nhiều chỉ số cùng lúc: CMIN/df, CFI, TLI, RMSEA, SRMR.
- Chỉ chỉnh mô hình theo Modification Indices khi có lý do lý thuyết rõ ràng.
Nội dung bài viết
- Phân tích SEM là gì và khi nào nên dùng?
- Bước 1: Kiểm định mô hình đo lường bằng CFA
- Bước 2 và 3: Vẽ mô hình và thiết lập phân tích SEM trên AMOS
- Bước 4: Đọc kết quả phân tích SEM trong AMOS Output
- Bước 5: Kiểm định tác động gián tiếp bằng bootstrap
- Bước 6: Đánh giá độ phù hợp của mô hình phân tích SEM
- Bước 7: Hiệu chỉnh mô hình bằng Modification Indices có lý thuyết
- Cách viết kết quả phân tích SEM trong luận văn theo APA
- Lỗi thường gặp khi phân tích SEM trên AMOS
- Checklist hoàn thành phân tích SEM
- Câu hỏi thường gặp về phân tích SEM
- Tài liệu tham khảo
Phân tích SEM là gì và khi nào nên dùng?
SEM (Structural Equation Modeling) kết hợp hai thành phần: mô hình đo lường, mô tả cách các biến quan sát phản ánh khái niệm tiềm ẩn, và mô hình cấu trúc, mô tả quan hệ giữa các khái niệm. Khác với hồi quy bội, phân tích SEM ước lượng toàn bộ hệ phương trình trong một lần và không giả định thang đo hoàn hảo.
Bạn nên chọn phân tích SEM dựa trên hiệp phương sai (CB-SEM, như AMOS) khi mục tiêu là kiểm định lý thuyết đã có, mô hình có nhiều biến phụ thuộc nối tiếp nhau, hoặc cần kiểm định biến trung gian một cách chặt chẽ. Nếu mục tiêu thiên về dự báo, mẫu nhỏ hoặc có thang đo dạng cấu tạo (formative), hãy cân nhắc PLS-SEM trên SmartPLS.
Điều kiện dữ liệu trước khi phân tích SEM
Khi phân tích SEM, phương pháp ước lượng mặc định của AMOS là Maximum Likelihood (ML), vốn giả định phân phối chuẩn đa biến. Bạn cần kiểm tra các điều kiện sau trước khi chạy mô hình:
- Cỡ mẫu: Kline (2016) lưu ý rằng mô hình càng phức tạp càng cần mẫu lớn; với mô hình 4 đến 5 khái niệm, nhiều nghiên cứu dùng từ 200 quan sát trở lên. Xem thêm cách tính cỡ mẫu.
- Dữ liệu thiếu: AMOS không chạy bootstrap và không tính Modification Indices khi có ô trống, nên cần xử lý missing trong SPSS trước.
- Phân phối: kiểm tra độ lệch, độ nhọn từng biến và hệ số Mardia trong mục Assessment of normality.
- Thang đo đã sàng lọc: đã qua Cronbach's Alpha và EFA, các biến rác đã được loại.
Bước 1: Kiểm định mô hình đo lường bằng CFA
Anderson và Gerbing (1988) đề xuất cách tiếp cận hai bước: chỉ khi mô hình đo lường đạt yêu cầu thì mới chuyển sang mô hình cấu trúc. Lý do là nếu thang đo kém, mọi kết quả phân tích SEM phía sau đều khó diễn giải. Bạn có thể xem hướng dẫn chi tiết tại bài phân tích CFA trên AMOS.
Ở bước CFA, các khái niệm được nối với nhau bằng mũi tên hai chiều (hiệp phương sai). Bạn đánh giá hệ số tải chuẩn hóa, độ tin cậy tổng hợp (CR), phương sai trích trung bình (AVE) và giá trị phân biệt theo tiêu chí Fornell và Larcker (1981) hoặc HTMT.
| Tiêu chí CFA | Ngưỡng thường dùng | Nguồn tham chiếu |
|---|---|---|
| Hệ số tải chuẩn hóa | ≥ 0,708 (thang đo phản ánh) | Hair và cộng sự (2019) |
| Độ tin cậy tổng hợp CR | ≥ 0,7 | Fornell & Larcker (1981); Hair và cộng sự (2019) |
| AVE | ≥ 0,5 | Fornell & Larcker (1981) |
| Giá trị phân biệt | Căn bậc hai AVE lớn hơn tương quan giữa các khái niệm | Fornell & Larcker (1981) |
Bước 2 và 3: Vẽ mô hình và thiết lập phân tích SEM trên AMOS
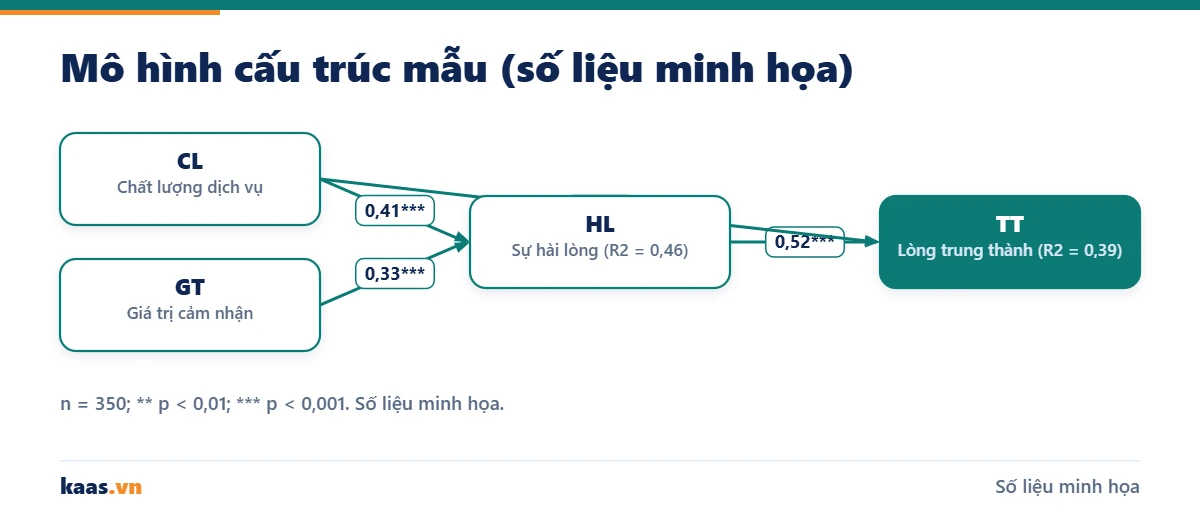
Giả sử bạn cần phân tích SEM cho bốn khái niệm (số liệu minh họa, n = 350): Chất lượng dịch vụ (CL, 5 biến quan sát), Giá trị cảm nhận (GT, 4 biến), Sự hài lòng (HL, 4 biến) và Lòng trung thành (TT, 4 biến). Giả thuyết: CL và GT tác động đến HL; HL tác động đến TT; CL tác động trực tiếp đến TT.
- Kết nối dữ liệu. Vào File > Data Files > File Name, chọn file .sav đã làm sạch rồi bấm OK.
- Chuyển từ sơ đồ CFA. Lưu sơ đồ CFA thành file mới, xóa các mũi tên hai chiều nối với HL và TT, chỉ giữ hiệp phương sai giữa CL và GT.
- Vẽ đường dẫn. Dùng công cụ mũi tên một chiều (Draw paths) nối CL và GT sang HL, HL sang TT, CL sang TT.
- Thêm phần dư. Dùng công cụ Add a unique variable to an existing variable cho HL và TT, sau đó vào Plugins > Name Unobserved Variables để đặt tên tự động.
- Thiết lập đầu ra. Mở View > Analysis Properties, thẻ Output, tích Standardized estimates, Squared multiple correlations, Modification indices (ngưỡng 4) và Indirect, direct & total effects.
- Bật bootstrap. Ở thẻ Bootstrap, tích Perform bootstrap, nhập 2000 hoặc 5000 mẫu, tích Bias-corrected confidence intervals và đổi mức tin cậy thành 95.
Cuối cùng chọn Analyze > Calculate Estimates (Ctrl + F9) để AMOS thực hiện phân tích SEM. Nếu biểu tượng mũi tên đỏ chuyển sáng, bấm View the output path diagram để xem hệ số trên sơ đồ, chọn Standardized estimates ở khung bên trái.
Mẹo: khi phân tích SEM với nhiều khái niệm, hãy đặt các khái niệm theo chiều trái sang phải đúng trình tự nhân quả và dùng công cụ Touch up a variable để AMOS tự sắp xếp mũi tên. Sơ đồ gọn giúp bạn phát hiện nhanh đường dẫn vẽ nhầm chiều.
Bước 4: Đọc kết quả phân tích SEM trong AMOS Output
Cửa sổ Amos Output có cây mục bên trái. Phần quan trọng nhất nằm ở Estimates > Scalars, gồm Regression Weights, Standardized Regression Weights, Covariances, Correlations và Squared Multiple Correlations.
Regression Weights và Standardized Regression Weights
Bảng Regression Weights cho hệ số chưa chuẩn hóa (Estimate), sai số chuẩn (S.E.), tỉ số tới hạn (C.R. = Estimate chia S.E.) và giá trị P. Ký hiệu *** nghĩa là \(p < 0{,}001\). Một đường dẫn có ý nghĩa thống kê khi \(|C.R.| > 1{,}96\) tương ứng \(p < 0{,}05\).
Bảng Standardized Regression Weights cho hệ số \(\beta\) chuẩn hóa, dùng để so sánh mức độ tác động giữa các biến độc lập. Khi viết báo cáo, bạn lấy \(\beta\) từ bảng chuẩn hóa và giá trị p từ bảng chưa chuẩn hóa, vì AMOS không in p ở bảng chuẩn hóa.
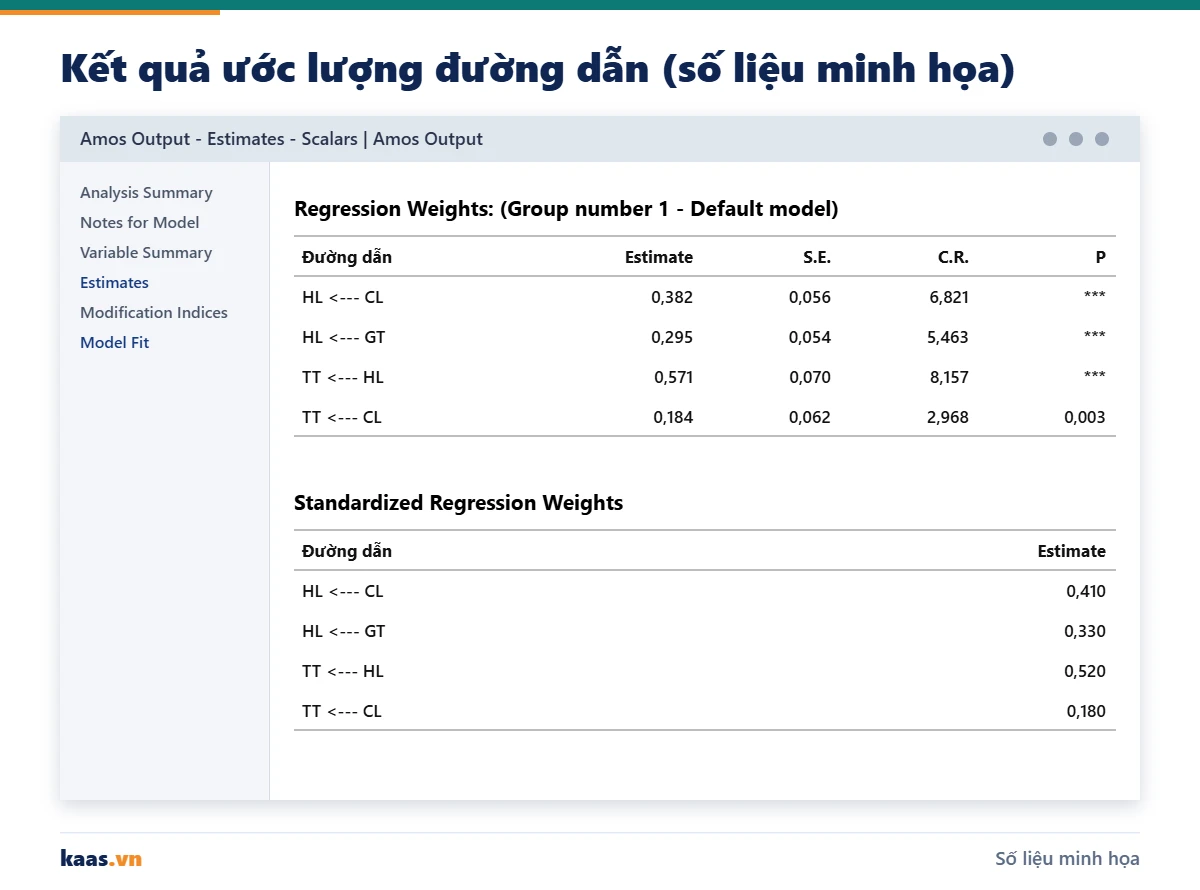
| Đường dẫn (số liệu minh họa) | \(\beta\) chuẩn hóa | C.R. | P | Kết luận |
|---|---|---|---|---|
| CL → HL | 0,41 | 6,82 | *** | H1 được ủng hộ |
| GT → HL | 0,33 | 5,47 | *** | H2 được ủng hộ |
| HL → TT | 0,52 | 8,15 | *** | H3 được ủng hộ |
| CL → TT | 0,18 | 2,96 | 0,003 | H4 được ủng hộ |
Hệ số xác định R2 trong phân tích SEM
Bảng Squared Multiple Correlations cho \(R^2\) của từng biến nội sinh. Trong ví dụ, \(R^2\) của HL là 0,46, nghĩa là CL và GT cùng giải thích 46% biến thiên của sự hài lòng; \(R^2\) của TT là 0,39.
Bước 5: Kiểm định tác động gián tiếp bằng bootstrap
Trong mô hình mẫu, CL tác động đến TT qua HL. Tác động gián tiếp chuẩn hóa bằng tích hai hệ số: 0,41 × 0,52 ≈ 0,21. Với phân tích SEM có biến trung gian, Preacher và Hayes (2008) khuyến nghị kiểm định tác động gián tiếp bằng bootstrap vì phân phối của tích hai hệ số thường lệch, khiến kiểm định Sobel kém tin cậy.
Trong Amos Output, mở Estimates > Matrices > Standardized Indirect Effects. Ở khung phía dưới cây mục, chọn Bootstrap confidence, sau đó Bias-corrected percentile method, bạn sẽ thấy Lower Bounds, Upper Bounds và Two Tailed Significance (BC). Ví dụ minh họa: khoảng tin cậy 95% là [0,14; 0,29], p = 0,001, không chứa 0, nên tác động gián tiếp có ý nghĩa.
Vì CL vẫn tác động trực tiếp đến TT (\(\beta = 0{,}18\), p = 0,003), HL đóng vai trò trung gian một phần. Phần lý thuyết về các loại trung gian được trình bày kỹ trong bài phân tích biến trung gian.
Lưu ý: mục Indirect Effects của AMOS gộp mọi đường gián tiếp giữa hai biến. Khi mô hình có từ hai biến trung gian song song trở lên, bạn cần định nghĩa tham số riêng bằng Estimand (User-defined estimand) để tách từng tác động cụ thể.
Bước 6: Đánh giá độ phù hợp của mô hình phân tích SEM
Mục Model Fit trong Amos Output gồm các bảng CMIN, RMR, GFI, Baseline Comparisons, RMSEA. Riêng SRMR không nằm sẵn trong output: bạn mở Plugins > Standardized RMR, để cửa sổ đó mở, rồi chạy lại Calculate Estimates để nhận giá trị.
| Chỉ số | Ngưỡng tốt | Nguồn | Ví dụ minh họa |
|---|---|---|---|
| CMIN/df | ≤ 3 (một số tác giả chấp nhận ≤ 5) | Quy ước thực hành; Kline (2016) không khuyến khích dựa vào tỉ số này | 2,17 |
| CFI | ≥ 0,95 (0,90 chấp nhận được) | Hu & Bentler (1999) | 0,957 |
| TLI | ≥ 0,95 | Hu & Bentler (1999) | 0,949 |
| RMSEA | ≤ 0,06; kèm khoảng tin cậy 90% | Hu & Bentler (1999) | 0,058 |
| SRMR | ≤ 0,08 | Hu & Bentler (1999) | 0,046 |
Với số liệu minh họa: \(\chi^2 = 247{,}8\), df = 114, CMIN/df = 2,17, CFI = 0,957, TLI = 0,949, RMSEA = 0,058 (90% CI [0,048; 0,068]), PCLOSE = 0,093, SRMR = 0,046. TLI thấp hơn 0,95 một chút nhưng các chỉ số còn lại đạt, nên mô hình được xem là phù hợp với dữ liệu. Giải thích chi tiết từng chỉ số có trong bài chỉ số model fit.
Kiểm định \(\chi^2\) thường có ý nghĩa (p < 0,05) khi mẫu lớn, kể cả khi mô hình khá tốt. Kline (2016) khuyên vẫn phải báo cáo \(\chi^2\) và giải thích, thay vì bỏ qua nó.
Bước 7: Hiệu chỉnh mô hình bằng Modification Indices có lý thuyết
Khi kết quả phân tích SEM cho độ phù hợp chưa đạt, AMOS gợi ý ở mục Modification Indices, gồm ba bảng Covariances, Variances và Regression Weights. Cột M.I. cho biết \(\chi^2\) sẽ giảm khoảng bao nhiêu nếu giải phóng tham số đó; cột Par Change là thay đổi ước tính của tham số.
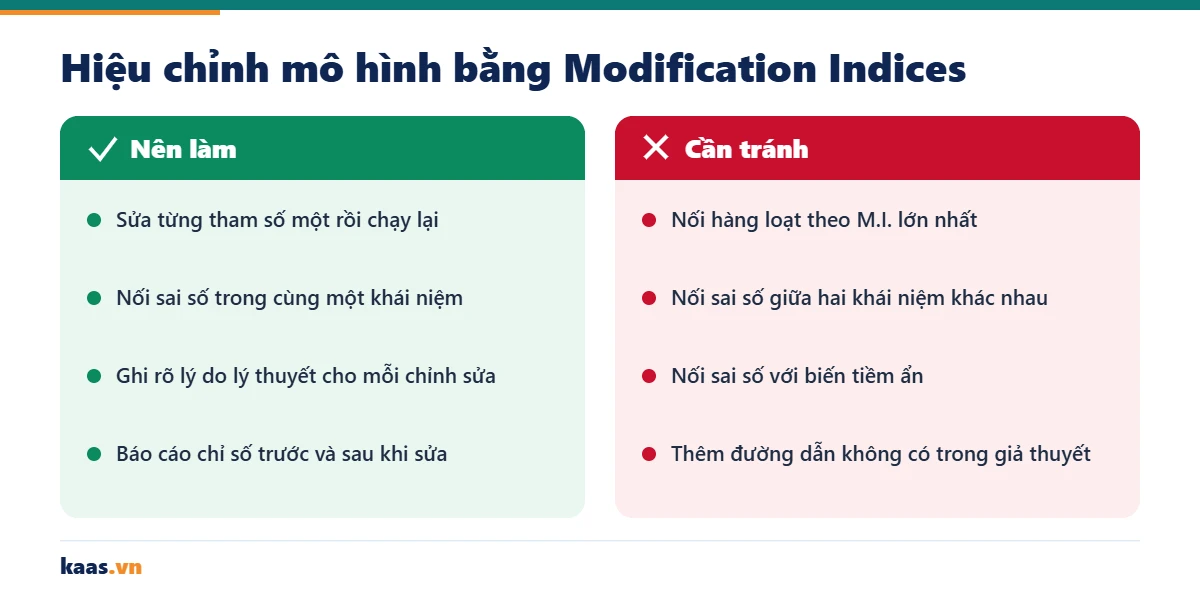
- Được chấp nhận: nối hiệp phương sai giữa hai sai số của cùng một khái niệm khi hai câu hỏi có cách diễn đạt gần giống nhau.
- Cần thận trọng: nối sai số thuộc hai khái niệm khác nhau, hoặc thêm đường dẫn mới không có trong giả thuyết.
- Không nên: nối sai số với biến tiềm ẩn, hoặc nối hàng loạt theo M.I. lớn nhất chỉ để đẹp chỉ số.
Cách viết kết quả phân tích SEM trong luận văn theo APA
Một đoạn báo cáo kết quả phân tích SEM chuẩn APA cần nêu: phương pháp ước lượng, chỉ số phù hợp, hệ số chuẩn hóa kèm p, \(R^2\) và kết quả bootstrap. Bạn có thể tham khảo mẫu sau (số liệu minh họa):
Ví dụ: Mô hình cấu trúc được ước lượng bằng phương pháp Maximum Likelihood trên AMOS 26 với n = 350. Mô hình phù hợp với dữ liệu, \(\chi^2(114) = 247{,}8\), \(p < 0{,}001\), CFI = 0,957, TLI = 0,949, RMSEA = 0,058, 90% CI [0,048; 0,068], SRMR = 0,046. Chất lượng dịch vụ (\(\beta = 0{,}41\), \(p < 0{,}001\)) và giá trị cảm nhận (\(\beta = 0{,}33\), \(p < 0{,}001\)) tác động cùng chiều đến sự hài lòng, \(R^2 = 0{,}46\).
Tác động gián tiếp của chất lượng dịch vụ đến lòng trung thành qua sự hài lòng có ý nghĩa, \(\beta = 0{,}21\), 95% BC CI [0,14; 0,29], dựa trên 5.000 mẫu bootstrap.
Trong chương 4, nên trình bày theo trình tự: thống kê mẫu, độ tin cậy, EFA, CFA, sau đó mới đến phân tích SEM và kiểm định giả thuyết.
Lỗi thường gặp khi phân tích SEM trên AMOS
Bảng dưới tổng hợp các lỗi phổ biến nhất khi phân tích SEM và cách khắc phục.
| Lỗi hoặc thông báo | Nguyên nhân | Cách xử lý |
|---|---|---|
| Bootstrap không chạy hoặc báo lỗi missing | Dữ liệu có ô trống | Xử lý dữ liệu thiếu trong SPSS rồi kết nối lại file |
| Unidentified model, thiếu ràng buộc | Chưa cố định một hệ số tải bằng 1 hoặc thiếu phần dư | Đặt Regression weight = 1 cho một biến mỗi khái niệm, thêm phần dư cho biến nội sinh |
| The following variances are negative (Heywood case) | Mẫu nhỏ, khái niệm chỉ có 2 biến, mô hình sai | Kiểm tra lại thang đo, cân nhắc tăng mẫu hoặc gộp khái niệm |
| Không có bảng Modification Indices | Dữ liệu thiếu hoặc chưa tích trong Output | Làm sạch dữ liệu, tích Modification indices |
Một lỗi khác ít được nhắc đến là quên kiểm tra sai lệch phương pháp chung khi mọi biến lấy từ cùng một bảng hỏi. Hãy đọc bài Common Method Bias để bổ sung kiểm định này trước khi diễn giải kết quả phân tích SEM. Nếu cần so sánh mô hình giữa nam và nữ hay giữa các vùng, bước tiếp theo là phân tích đa nhóm.
Checklist hoàn thành phân tích SEM
- Dữ liệu không còn ô trống, đã kiểm tra outlier và độ lệch, độ nhọn.
- Thang đo đã qua Cronbach's Alpha, EFA và CFA; CR, AVE và giá trị phân biệt đạt.
- Sơ đồ có phần dư cho mọi biến nội sinh, chỉ giữ hiệp phương sai giữa các biến ngoại sinh.
- Đã tích Standardized estimates, Squared multiple correlations, Indirect effects và bật bootstrap.
- Kết quả phân tích SEM báo cáo đủ \(\chi^2\), df, CFI, TLI, RMSEA kèm khoảng tin cậy, SRMR.
- Mỗi chỉnh sửa theo Modification Indices đều có lý do lý thuyết và được ghi lại.
- Bảng kết quả có \(\beta\) chuẩn hóa, p, \(R^2\) và khoảng tin cậy bootstrap cho tác động gián tiếp.
Câu hỏi thường gặp về phân tích SEM
Phân tích SEM cần cỡ mẫu tối thiểu bao nhiêu?
Không có con số duy nhất. Kline (2016) nhấn mạnh cỡ mẫu phụ thuộc độ phức tạp mô hình, số tham số và phân phối dữ liệu. Trong thực hành, phân tích SEM với mẫu từ 200 trở lên thường đủ ổn định cho mô hình 4 đến 6 khái niệm với ước lượng ML.
Có bắt buộc chạy CFA trước khi phân tích SEM?
Nên có. Cách tiếp cận hai bước của Anderson và Gerbing (1988) giúp tách vấn đề đo lường khỏi vấn đề cấu trúc, nhờ đó bạn biết mô hình kém là do thang đo hay do giả thuyết.
Lấy giá trị p cho hệ số chuẩn hóa ở đâu?
AMOS chỉ in p ở bảng Regression Weights (chưa chuẩn hóa). Kiểm định ý nghĩa của hệ số chuẩn hóa và chưa chuẩn hóa là tương đương trong trường hợp này, nên bạn ghép \(\beta\) chuẩn hóa với p của dòng tương ứng.
Chỉ số TLI hoặc RMSEA chưa đạt thì có phải bỏ mô hình?
Không nhất thiết. Hu và Bentler (1999) khuyến nghị xem xét kết hợp nhiều chỉ số; một chỉ số hơi dưới ngưỡng trong khi các chỉ số khác tốt vẫn có thể chấp nhận, miễn là bạn giải thích minh bạch.
Khi nào dùng AMOS, khi nào dùng SmartPLS?
AMOS phù hợp khi phân tích SEM để kiểm định lý thuyết với thang đo phản ánh và dữ liệu gần chuẩn. SmartPLS phù hợp hơn cho mục tiêu dự báo, mô hình rất phức tạp hoặc có thang đo cấu tạo.
Cần người đồng hành khi chạy AMOS?
Kaas.vn hướng dẫn từng bước phân tích SEM qua dịch vụ hỗ trợ AMOS, giải thích kết quả và bàn giao file để bạn tự chạy lại; chúng tôi không viết thay và không chỉnh số liệu. Bạn cũng có thể luyện tập trước với bộ dữ liệu thực hành.
Tài liệu tham khảo
- Anderson, J. C., & Gerbing, D. W. (1988). Structural equation modeling in practice: A review and recommended two-step approach. Psychological Bulletin, 103(3), 411-423. doi:10.1037/0033-2909.103.3.411
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39-50. doi:10.2307/3151312
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2-24. doi:10.1108/EBR-11-2018-0203
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis. Structural Equation Modeling, 6(1), 1-55. doi:10.1080/10705519909540118
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879-891. doi:10.3758/BRM.40.3.879
Gửi mô hình (ảnh, Word, PDF) và chọn SPSS, AMOS, SmartPLS, Stata, Eviews hoặc R. Kaas.vn đề xuất phương án và báo giá miễn phí.
- PROCESS Macro của Hayes: 4 mô hình trung gian, điều tiết trên SPSS
- Phân tích độ tin cậy Cronbach's Alpha trong SPSS
- Hồi quy tuyến tính bội trong SPSS: 6 bước chạy và đọc kết quả chính xác
- Hỗ trợ chạy Stata: 6 bước phân tích dữ liệu bảng, hồi quy và kiểm định
- SPSS AMOS là gì? Hướng dẫn 7 bước chạy CFA và SEM trên IBM SPSS AMOS