Chỉ số model fit là nhóm thước đo cho biết ma trận hiệp phương sai do mô hình CFA hoặc SEM tái tạo khớp với dữ liệu thực tế đến mức nào. Đây là phần mà hội đồng chấm luận văn gần như luôn hỏi, vì một mô hình không phù hợp thì mọi hệ số phía sau đều khó tin cậy.
Bài viết giải thích từng chỉ số model fit thường gặp trên AMOS (Chi-square/df, CFI, TLI, GFI, RMSEA, PCLOSE, SRMR), ngưỡng đánh giá theo Hu và Bentler (1999) cùng quan điểm của Kline (2016), cách xuất kết quả, ví dụ đọc số liệu và những cách cải thiện mô hình được chấp nhận về mặt học thuật. Mọi con số trong ví dụ là số liệu minh họa.
Điểm chính của bài
- Không có chỉ số model fit nào đủ một mình; hãy báo cáo tối thiểu \(\chi^2\), df, CFI, RMSEA kèm khoảng tin cậy 90% và SRMR.
- Ngưỡng của Hu và Bentler (1999): CFI, TLI gần 0,95; RMSEA gần 0,06; SRMR gần 0,08.
- CMIN/df và GFI là quy ước thực hành, không phải tiêu chuẩn bắt buộc.
- SRMR trên AMOS phải lấy qua Plugins > Standardized RMR.
- Chỉ cải thiện độ phù hợp bằng chỉnh sửa có cơ sở lý thuyết, không nối sai số tùy tiện.
Nội dung bài viết
- Chỉ số model fit là gì và vì sao cần nhiều chỉ số?
- Bảng ngưỡng chỉ số model fit theo các tác giả
- Giải thích từng chỉ số model fit trên AMOS
- Cách xuất chỉ số model fit trên AMOS
- Ví dụ đọc chỉ số model fit trước và sau hiệu chỉnh
- Cách cải thiện chỉ số model fit hợp lệ
- Cách viết chỉ số model fit trong luận văn theo APA
- Lỗi thường gặp khi đánh giá chỉ số model fit
- Checklist kiểm tra chỉ số model fit
- Câu hỏi thường gặp về chỉ số model fit
- Tài liệu tham khảo
Chỉ số model fit là gì và vì sao cần nhiều chỉ số?
Khi chạy CFA hay SEM bằng phương pháp hiệp phương sai, phần mềm so sánh ma trận hiệp phương sai mẫu với ma trận mà mô hình ngụ ý. Khoảng cách giữa hai ma trận càng nhỏ, mô hình càng phù hợp. Mỗi chỉ số model fit đo khoảng cách này theo một góc nhìn khác nhau.
Các chỉ số được chia thành ba nhóm chính. Mỗi nhóm có điểm mạnh và điểm yếu riêng, nên báo cáo kết hợp nhiều nhóm giúp đánh giá cân bằng hơn.
- Chỉ số tuyệt đối: \(\chi^2\), CMIN/df, GFI, RMSEA, SRMR, đánh giá mô hình so với dữ liệu mà không so với mô hình khác.
- Chỉ số tăng thêm (incremental): CFI, TLI, NFI, IFI, so sánh mô hình của bạn với mô hình độc lập (Independence model), nơi mọi biến không tương quan.
- Chỉ số điều chỉnh theo tính tiết kiệm: AGFI, PGFI, PNFI, AIC, phạt mô hình có quá nhiều tham số tự do.
Hu và Bentler (1999) cho thấy mỗi chỉ số model fit nhạy với các loại sai lệch khác nhau: SRMR nhạy với sai lệch trong phần hiệp phương sai giữa các nhân tố, còn CFI, TLI và RMSEA nhạy hơn với sai lệch hệ số tải. Đó là lý do các tác giả đề xuất chiến lược kết hợp hai chỉ số.
Bảng ngưỡng chỉ số model fit theo các tác giả
Bảng dưới tổng hợp ngưỡng chỉ số model fit được dùng phổ biến nhất. Khi các tác giả khác nhau, cột cuối nêu rõ nguồn để bạn trích dẫn đúng.
| Chỉ số | Ngưỡng tốt | Ngưỡng chấp nhận | Nguồn |
|---|---|---|---|
| \(\chi^2\) (p) | p > 0,05 | Thường có ý nghĩa khi mẫu lớn | Kline (2016) |
| CMIN/df | ≤ 3 | ≤ 5 theo một số tác giả | Quy ước thực hành |
| CFI | ≥ 0,95 | ≥ 0,90 | Hu & Bentler (1999); 0,90 là ngưỡng truyền thống |
| TLI | ≥ 0,95 | ≥ 0,90 | Hu & Bentler (1999) |
| GFI | ≥ 0,90 | Không khuyến khích dùng làm tiêu chí chính | Quy ước thực hành; Kline (2016) |
| RMSEA | ≤ 0,06 | ≤ 0,08 | Hu & Bentler (1999); 0,08 là ngưỡng truyền thống |
| PCLOSE | > 0,05 | Đọc cùng khoảng tin cậy RMSEA | Kiểm định RMSEA ≤ 0,05 |
| SRMR | ≤ 0,08 | Kết hợp với CFI hoặc RMSEA | Hu & Bentler (1999) |
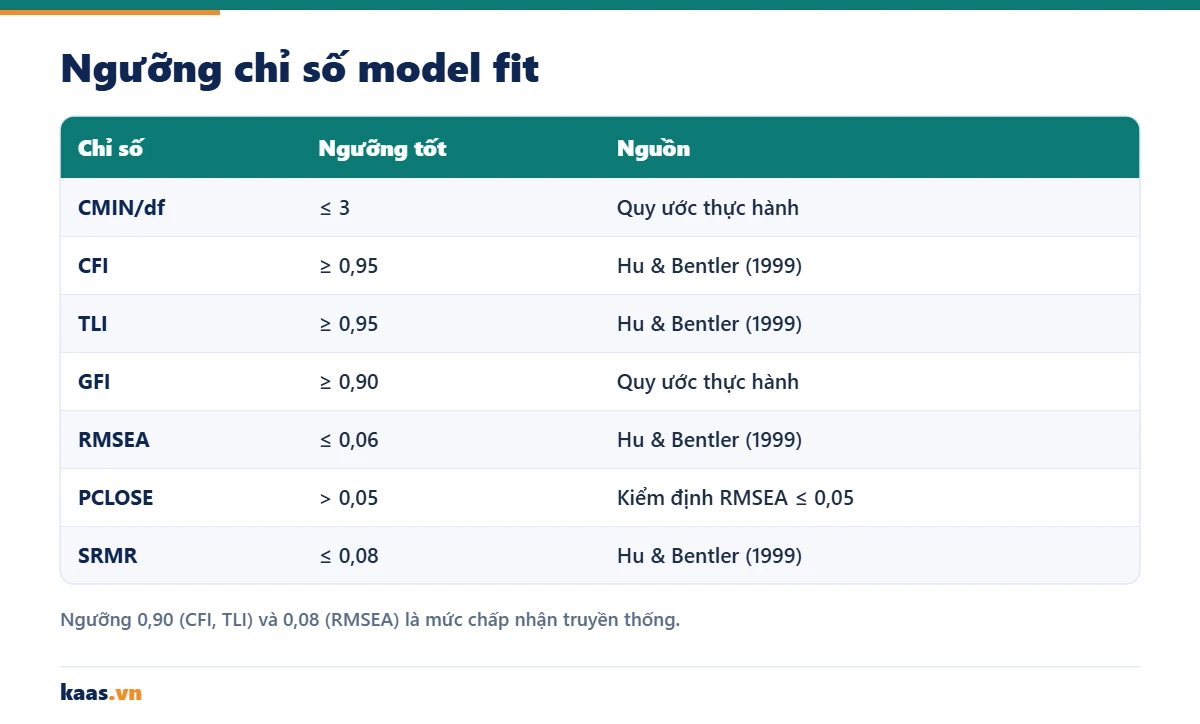
Lưu ý: Hu và Bentler (1999) dùng cụm "gần với" (close to) 0,95, 0,06 và 0,08, dựa trên mô phỏng với điều kiện cụ thể. Bản thân các tác giả và Kline (2016) đều cảnh báo không nên coi đây là ngưỡng cứng tuyệt đối cho mọi mô hình.
Giải thích từng chỉ số model fit trên AMOS
Chi-square và CMIN/df
\(\chi^2\) kiểm định giả thuyết rằng mô hình tái tạo hoàn hảo ma trận hiệp phương sai tổng thể. Giá trị p lớn hơn 0,05 là tốt. Vấn đề là \(\chi^2\) tăng theo cỡ mẫu, nên với mẫu từ 300 trở lên, gần như mô hình nào cũng có \(p < 0{,}05\). Kline (2016) vẫn yêu cầu báo cáo và giải thích kiểm định này chứ không bỏ qua.
CMIN/df là \(\chi^2\) chia số bậc tự do, được dùng để giảm ảnh hưởng của cỡ mẫu. Ngưỡng ≤ 3 hay ≤ 5 là quy ước thực hành, không có cơ sở thống kê chặt chẽ, nên đừng dùng nó làm chỉ số model fit duy nhất.
CFI và TLI trong nhóm chỉ số model fit tăng thêm
CFI (Comparative Fit Index) đo mức cải thiện của mô hình so với mô hình độc lập, có giá trị từ 0 đến 1:
Trong đó M là mô hình nghiên cứu, B là mô hình độc lập (baseline). TLI (Tucker-Lewis Index) có thêm phần phạt mô hình phức tạp, có thể vượt 1 hoặc thấp hơn CFI một chút. Hai chỉ số này thường đi cùng nhau trong bảng Baseline Comparisons.
GFI và AGFI
GFI cho biết tỉ lệ hiệp phương sai mẫu được mô hình giải thích, AGFI điều chỉnh theo bậc tự do. Cả hai chịu ảnh hưởng mạnh của cỡ mẫu và số biến quan sát. Kline (2016) không khuyến khích dựa vào GFI, AGFI; bạn có thể báo cáo kèm theo nhưng không nên dùng làm căn cứ chính.
NFI, IFI và AIC
Bảng Baseline Comparisons còn có NFI và IFI. NFI bị chệch xuống khi mẫu nhỏ, nên ngày nay ít được dùng làm căn cứ chính; IFI ổn định hơn và thường có giá trị gần CFI.
Mục AIC, BCC và ECVI không có ngưỡng tuyệt đối, chỉ dùng để so sánh hai mô hình cạnh tranh ước lượng trên cùng một bộ dữ liệu: mô hình có AIC nhỏ hơn được ưu tiên. Đây là chỉ số model fit hữu ích khi bạn cân nhắc giữa mô hình bốn nhân tố và mô hình gộp thành ba nhân tố.
RMSEA và PCLOSE
RMSEA (Root Mean Square Error of Approximation) đo mức sai lệch trên mỗi bậc tự do, có tính đến cỡ mẫu N:
AMOS in thêm LO 90 và HI 90 (khoảng tin cậy 90%) cùng PCLOSE, là p của kiểm định giả thuyết RMSEA tổng thể không lớn hơn 0,05. PCLOSE > 0,05 nghĩa là chưa có bằng chứng mô hình kém. Với mô hình có df nhỏ và mẫu nhỏ, RMSEA thường bị phóng đại, nên hãy đọc cả khoảng tin cậy.
SRMR
SRMR là căn bậc hai trung bình bình phương phần dư chuẩn hóa giữa ma trận tương quan quan sát và ma trận ngụ ý. Giá trị 0 là khớp hoàn hảo. Đây là chỉ số model fit mà Hu và Bentler (1999) khuyên ghép cặp với CFI, TLI hoặc RMSEA, ví dụ CFI ≥ 0,96 kèm SRMR ≤ 0,09, hoặc RMSEA ≤ 0,06 kèm SRMR ≤ 0,09.
Cách xuất chỉ số model fit trên AMOS
Từ AMOS 24 đến AMOS 29, cách lấy kết quả không thay đổi đáng kể. Các bước như sau:
- Kết nối dữ liệu. Vào File > Data Files, chọn file .sav không còn ô trống.
- Chọn đầu ra. Mở View > Analysis Properties, thẻ Output, tích Standardized estimates và Modification indices (Threshold for modification indices để mặc định 4).
- Mở plugin SRMR. Chọn Plugins > Standardized RMR. Một cửa sổ trống hiện ra, giữ nguyên không đóng.
- Chạy mô hình. Chọn Analyze > Calculate Estimates. Cửa sổ Standardized RMR sẽ hiển thị giá trị SRMR.
- Đọc kết quả. Mở View > Text Output, chọn mục Model Fit ở cây bên trái.
Trong mục Model Fit, mỗi bảng có ba dòng: Default model (mô hình của bạn), Saturated model (mô hình bão hòa, df = 0) và Independence model. Bạn chỉ lấy chỉ số model fit ở dòng Default model. Các bảng cần đọc là CMIN, RMR GFI, Baseline Comparisons và RMSEA.
Mẹo: nếu Plugins > Standardized RMR báo lỗi hoặc không hiện số, hãy kiểm tra dữ liệu có ô trống không, vì plugin cần ma trận hiệp phương sai đầy đủ. Đóng cửa sổ rồi mở lại plugin trước khi chạy lại cũng thường giải quyết được.
Ví dụ đọc chỉ số model fit trước và sau hiệu chỉnh
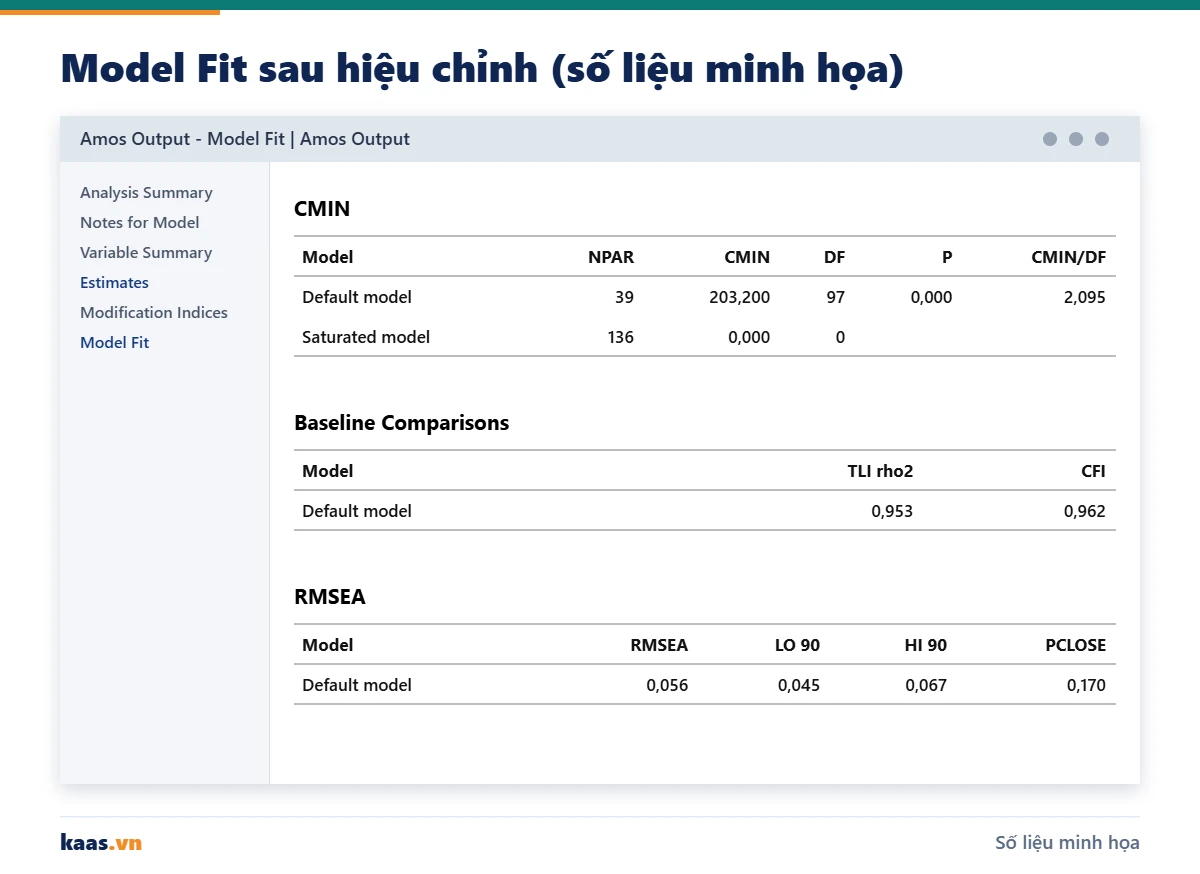
Giả sử một mô hình CFA gồm 4 nhân tố với 17 biến quan sát, n = 350 (số liệu minh họa). Lần chạy đầu cho các chỉ số model fit chưa đạt. Phân tích chi tiết cho thấy biến TT4 có hệ số tải chuẩn hóa chỉ 0,48, đồng thời Modification Indices gợi ý nối sai số e3 và e4 của hai câu CL3, CL4 vốn được diễn đạt gần giống nhau.
| Chỉ số (số liệu minh họa) | Mô hình ban đầu | Sau hiệu chỉnh | Đánh giá |
|---|---|---|---|
| \(\chi^2\) (df) | 389,4 (113) | 203,2 (97) | Vẫn p < 0,001, do mẫu lớn |
| CMIN/df | 3,45 | 2,09 | Đạt ≤ 3 |
| CFI | 0,912 | 0,962 | Đạt ≥ 0,95 |
| TLI | 0,894 | 0,953 | Đạt ≥ 0,95 |
| GFI | 0,881 | 0,935 | Đạt ≥ 0,90 |
| RMSEA [90% CI] | 0,084 [0,075; 0,093] | 0,056 [0,045; 0,067] | Đạt ≤ 0,06 |
| PCLOSE | 0,000 | 0,170 | Đạt > 0,05 |
| SRMR | 0,061 | 0,041 | Đạt ≤ 0,08 |
Bạn có thể tự kiểm tra RMSEA của mô hình sau hiệu chỉnh: \(\chi^2 - df = 106{,}2\); chia cho \(97 \times 349\) được khoảng 0,00314; căn bậc hai bằng 0,056, khớp với AMOS. Bậc tự do giảm từ 113 xuống 97 vì loại một biến quan sát (giảm 15 bậc tự do) và thêm một hiệp phương sai sai số (giảm thêm 1).
Lần chạy đầu, SRMR đã dưới 0,08 nhưng CFI, TLI và RMSEA chưa đạt, đúng với nhận định của Hu và Bentler (1999) rằng các chỉ số tăng thêm và RMSEA nhạy với sai lệch hệ số tải. Sau khi loại biến tải thấp, bộ chỉ số model fit đều đạt ngưỡng.
Cách cải thiện chỉ số model fit hợp lệ
Mục tiêu không phải là "làm đẹp" chỉ số model fit mà là tìm ra phần mô hình chưa phản ánh đúng dữ liệu. Anderson và Gerbing (1988) nhấn mạnh hiệu chỉnh mô hình đo lường phải được thực hiện thận trọng và có giải thích.
Những cách cải thiện chỉ số model fit được chấp nhận
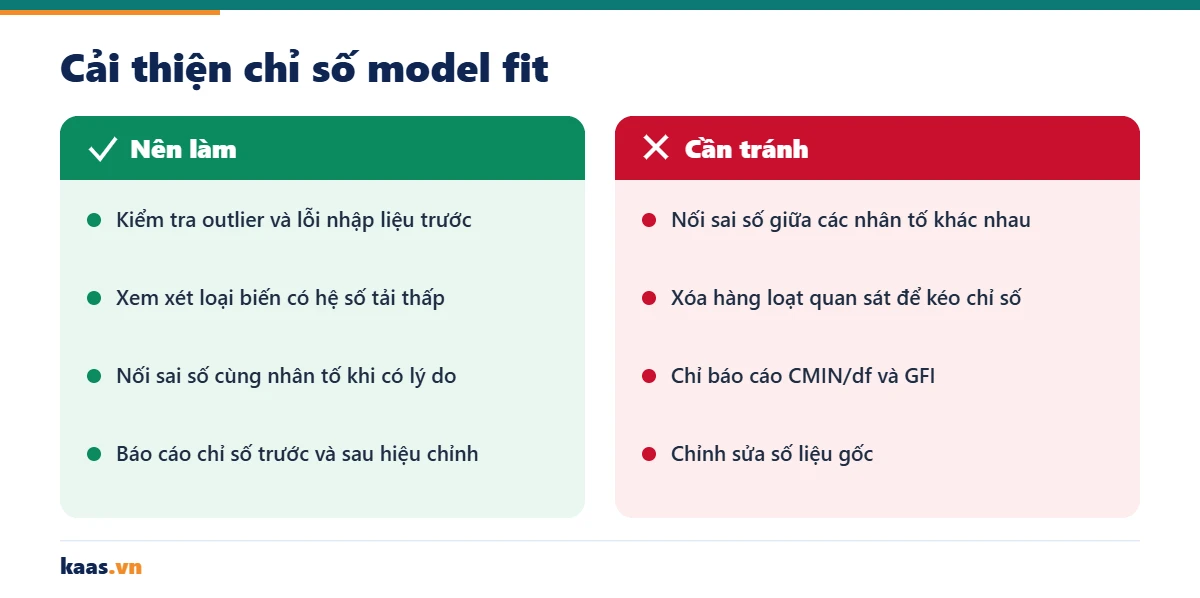
- Kiểm tra dữ liệu. Loại quan sát trả lời không nghiêm túc, xử lý outlier đa biến (khoảng cách Mahalanobis), kiểm tra lỗi nhập liệu.
- Xem hệ số tải. Biến có hệ số tải chuẩn hóa thấp (dưới 0,5) và làm giảm AVE có thể được loại, nếu nội dung khái niệm vẫn được bảo toàn (Fornell & Larcker, 1981).
- Đọc Modification Indices. Ưu tiên nối sai số giữa hai biến của cùng một nhân tố khi có lý do như cách diễn đạt trùng lặp hoặc cùng đảo chiều.
- Sửa từng bước. Mỗi lần chỉ thay đổi một tham số, chạy lại, ghi nhận \(\chi^2\) giảm bao nhiêu.
- Báo cáo minh bạch. Trình bày cả chỉ số model fit trước và sau hiệu chỉnh, nêu lý do từng thay đổi.
Những cách không nên dùng
Không nối sai số giữa các nhân tố khác nhau chỉ vì M.I. lớn, không nối sai số với biến tiềm ẩn, không xóa hàng loạt quan sát để kéo chỉ số lên, và tuyệt đối không chỉnh sửa số liệu gốc. Những thao tác này có thể làm chỉ số đẹp hơn nhưng khiến mô hình mất ý nghĩa lý thuyết và khó bảo vệ trước hội đồng.
Cách viết chỉ số model fit trong luận văn theo APA
Theo khuyến nghị của Kline (2016), đoạn báo cáo nên có \(\chi^2\) kèm df và p, RMSEA kèm khoảng tin cậy 90%, CFI và SRMR. TLI, CMIN/df có thể bổ sung tùy yêu cầu của trường.
Ví dụ: Kết quả CFA trên AMOS 26 (n = 350) cho thấy mô hình đo lường sau hiệu chỉnh phù hợp với dữ liệu, \(\chi^2(97) = 203{,}2\), \(p < 0{,}001\), \(\chi^2/df = 2{,}09\), CFI = 0,962, TLI = 0,953, RMSEA = 0,056, 90% CI [0,045; 0,067], SRMR = 0,041. Mặc dù kiểm định \(\chi^2\) có ý nghĩa, điều này thường gặp với mẫu lớn, và các chỉ số còn lại đều đạt ngưỡng của Hu và Bentler (1999). (Số liệu minh họa.)
Sau phần CFA, bạn dùng cùng bộ chỉ số này để đánh giá mô hình cấu trúc, xem hướng dẫn trong bài phân tích SEM trên AMOS. Nếu chưa nắm cách dựng mô hình đo lường, hãy đọc trước bài phân tích CFA trên AMOS.
Lỗi thường gặp khi đánh giá chỉ số model fit
| Lỗi | Hậu quả | Cách khắc phục |
|---|---|---|
| Chỉ báo cáo CMIN/df và GFI | Thiếu thông tin, dễ bị hội đồng chất vấn | Bổ sung CFI, RMSEA kèm CI, SRMR |
| Trích Hu & Bentler cho ngưỡng 0,90 | Trích dẫn sai nguồn | Ghi rõ 0,90 là ngưỡng truyền thống |
| Lấy số ở dòng Independence model | Kết luận sai hoàn toàn | Chỉ đọc dòng Default model |
| Nối sai số hàng loạt theo M.I. | Mô hình mất ý nghĩa lý thuyết | Sửa từng tham số, có lý do |
| Không có SRMR | Thiếu chỉ số Hu & Bentler khuyến nghị | Dùng Plugins > Standardized RMR |
Một lỗi tinh vi khác là đánh giá chỉ số model fit trong khi thang đo chưa đạt giá trị phân biệt. Mô hình có thể phù hợp tốt nhưng hai khái niệm thực chất trùng nhau, vì vậy hãy kiểm tra thêm HTMT. Khi so sánh giữa các nhóm khách hàng, cùng các chỉ số này còn được dùng để kiểm tra bất biến trong phân tích đa nhóm.
Checklist kiểm tra chỉ số model fit
- Dữ liệu không có ô trống, đã xử lý outlier, đã xem độ lệch và độ nhọn.
- Đã lấy số ở dòng Default model, không nhầm sang Saturated hay Independence.
- Bảng kết quả có \(\chi^2\), df, p, CMIN/df, CFI, TLI, RMSEA kèm 90% CI, PCLOSE và SRMR.
- Ngưỡng được trích đúng nguồn, ghi rõ khi dùng ngưỡng truyền thống 0,90 hoặc 0,08.
- Mọi hiệu chỉnh đều có lý do lý thuyết, có bảng so sánh trước và sau.
Câu hỏi thường gặp về chỉ số model fit
Chỉ số model fit nào quan trọng nhất?
Không có chỉ số nào quan trọng nhất. Bộ tối thiểu nên gồm \(\chi^2\) với df và p, CFI, RMSEA kèm khoảng tin cậy và SRMR, vì mỗi chỉ số nhạy với một loại sai lệch khác nhau.
CFI đạt 0,93 thì có chấp nhận được không?
Có thể chấp nhận theo ngưỡng truyền thống 0,90, nhưng chưa đạt mức "gần 0,95" của Hu và Bentler (1999). Bạn nên trình bày trung thực và xem xét các chỉ số khác như SRMR, RMSEA.
Vì sao p của Chi-square luôn nhỏ hơn 0,05?
Vì \(\chi^2\) tỉ lệ thuận với cỡ mẫu. Với vài trăm quan sát, sai lệch rất nhỏ cũng đủ có ý nghĩa thống kê, nên cần đọc kèm các chỉ số model fit khác.
AMOS không hiện SRMR thì làm thế nào?
SRMR không nằm trong Text Output. Bạn mở Plugins > Standardized RMR, giữ cửa sổ đó, rồi chạy lại Calculate Estimates để nhận giá trị.
Có được nối sai số để tăng chỉ số model fit?
Được, nếu hai sai số thuộc cùng một nhân tố và có lý do nội dung rõ ràng. Không nên nối sai số giữa các nhân tố khác nhau chỉ để tăng chỉ số.
Cần giải thích kết quả AMOS?
Kaas.vn hướng dẫn đọc và trình bày chỉ số model fit qua dịch vụ hỗ trợ AMOS, giải thích từng quyết định hiệu chỉnh và bàn giao file để bạn tự chạy lại; chúng tôi không viết thay, không chỉnh số liệu. Bạn có thể luyện tập với bộ dữ liệu thực hành.
Tài liệu tham khảo
- Anderson, J. C., & Gerbing, D. W. (1988). Structural equation modeling in practice: A review and recommended two-step approach. Psychological Bulletin, 103(3), 411-423. doi:10.1037/0033-2909.103.3.411
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39-50. doi:10.2307/3151312
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis. Structural Equation Modeling, 6(1), 1-55. doi:10.1080/10705519909540118
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
Gửi mô hình (ảnh, Word, PDF) và chọn SPSS, AMOS, SmartPLS, Stata, Eviews hoặc R. Kaas.vn đề xuất phương án và báo giá miễn phí.
- Phân tích định lượng là gì? 9 phương pháp phổ biến và cách chọn đúng
- Xử lý định lượng SPSS cho luận văn: 10 lưu ý quan trọng
- Hồi quy GMM: 6 bước chạy System GMM bằng xtabond2 trên Stata
- Dịch vụ phân tích dữ liệu nghiên cứu: quy trình 6 bước minh bạch, tái lập được
- Common Method Bias: 5 cách phòng ngừa và kiểm định trên SPSS, AMOS