Mô hình VAR (Vector Autoregression) là công cụ phân tích chuỗi thời gian đa biến, trong đó mỗi biến được giải thích bởi giá trị trễ của chính nó và của tất cả các biến còn lại. Từ khi Sims (1980) đề xuất như một cách tiếp cận ít áp đặt lý thuyết, VAR trở thành khung phân tích quen thuộc cho truyền dẫn chính sách tiền tệ, lạm phát và tăng trưởng.
Bài viết hướng dẫn quy trình đầy đủ trên EViews 12/13: kiểm tra tính dừng, chọn độ trễ, kiểm tra điều kiện ổn định, kiểm định nhân quả Granger, hàm phản ứng xung (IRF), phân rã phương sai, và khi nào cần chuyển sang VECM dựa trên kiểm định Johansen. Ví dụ dùng số liệu minh họa về kinh tế vĩ mô Việt Nam.
Điểm chính của bài
- Mô hình VAR chuẩn yêu cầu các biến dừng; biến I(1) không đồng liên kết thì lấy sai phân, có đồng liên kết thì dùng VECM.
- Chọn độ trễ theo bảng Lag Length Criteria, ưu tiên AIC hoặc tiêu chí được đa số chọn, rồi kiểm tra tự tương quan phần dư.
- Mọi nghiệm AR phải nằm trong vòng tròn đơn vị thì IRF và phân rã phương sai mới có nghĩa.
- IRF theo phân rã Cholesky phụ thuộc thứ tự biến; thứ tự phải được biện minh bằng lý thuyết.
- Nhân quả Granger chỉ là quan hệ dự báo trước, không phải nhân quả theo nghĩa cấu trúc.
Nội dung bài viết
- Mô hình VAR là gì và khi nào nên dùng
- Bước 1: Kiểm tra tính dừng trước khi ước lượng mô hình VAR
- Bước 2: Ước lượng và chọn độ trễ cho mô hình VAR trên EViews
- Bước 3: Kiểm tra điều kiện ổn định của mô hình VAR
- Bước 4: Kiểm định nhân quả Granger trong mô hình VAR
- Bước 5: Hàm phản ứng xung và thứ tự Cholesky
- Bước 6: Phân rã phương sai sai số dự báo
- Khi nào chuyển từ mô hình VAR sang VECM
- Chạy mô hình VAR trên Stata
- Viết kết quả mô hình VAR theo chuẩn APA
- Lỗi thường gặp khi ước lượng mô hình VAR
- Checklist trước khi báo cáo mô hình VAR
- Câu hỏi thường gặp về mô hình VAR
- Tài liệu tham khảo
Mô hình VAR là gì và khi nào nên dùng
Với ba biến tăng trưởng GDP, lạm phát và lãi suất, một mô hình VAR bậc p gồm ba phương trình, mỗi phương trình hồi quy một biến theo p trễ của cả ba biến. Viết gọn dưới dạng véc tơ:
Trong đó \(Y_t\) là véc tơ các biến nội sinh, \(A_i\) là ma trận hệ số và \(\varepsilon_t\) là véc tơ sai số có thể tương quan đồng thời giữa các phương trình. Vì vế phải chỉ chứa biến trễ, mỗi phương trình có thể ước lượng nhất quán bằng OLS.
Mô hình VAR phù hợp khi bạn tin rằng các biến tác động qua lại lẫn nhau và không muốn áp đặt biến nào là ngoại sinh. Mục tiêu thường là dự báo, phân tích phản ứng của hệ thống trước một cú sốc, hoặc kiểm tra biến nào giúp dự báo biến nào. Nếu câu hỏi chỉ xoay quanh một biến phụ thuộc với các biến giải thích ngoại sinh, mô hình ARDL thường gọn và dễ diễn giải hơn.
Mô hình VAR, VECM và ARDL khác nhau thế nào
| Tình huống dữ liệu | Mô hình phù hợp | Ghi chú |
|---|---|---|
| Tất cả biến I(0) | VAR ở dạng gốc | Trường hợp đơn giản nhất |
| Tất cả biến I(1), không đồng liên kết | VAR ở sai phân bậc 1 | Chỉ phân tích quan hệ ngắn hạn |
| Tất cả biến I(1), có đồng liên kết (Johansen) | VECM | Giữ thông tin dài hạn |
| Hỗn hợp I(0) và I(1), một biến phụ thuộc | ARDL và bounds test | Không dùng khi có biến I(2) |
Bước 1: Kiểm tra tính dừng trước khi ước lượng mô hình VAR
Trước khi ước lượng, chạy kiểm định ADF cho từng biến qua View > Unit Root Tests > Standard Unit Root Test trên cửa sổ series. Ví dụ (số liệu minh họa) dùng dữ liệu quý 2010Q1 đến 2024Q4 gồm GDPG (tăng trưởng GDP so cùng kỳ, %), INF (lạm phát so cùng kỳ, %) và IR (lãi suất liên ngân hàng kỳ hạn 3 tháng, %).
Kết quả minh họa: GDPG dừng ở dạng gốc (p = 0,012), INF dừng ở dạng gốc (p = 0,018), còn IR chỉ dừng sau khi lấy sai phân (p = 0,000 ở 1st difference). Vì vậy ta tạo biến DIR bằng lệnh series dir = d(ir) và đưa GDPG, INF, DIR vào mô hình VAR. Ở đây chỉ IR là I(1) nên không cần kiểm định đồng liên kết.
Lưu ý: Nếu nhiều biến cùng là I(1), đừng vội lấy sai phân tất cả. Hãy chạy kiểm định đồng liên kết Johansen trước; nếu có đồng liên kết, mô hình VAR ở sai phân bỏ sót thông tin dài hạn và bị đặc tả sai.
Bước 2: Ước lượng và chọn độ trễ cho mô hình VAR trên EViews
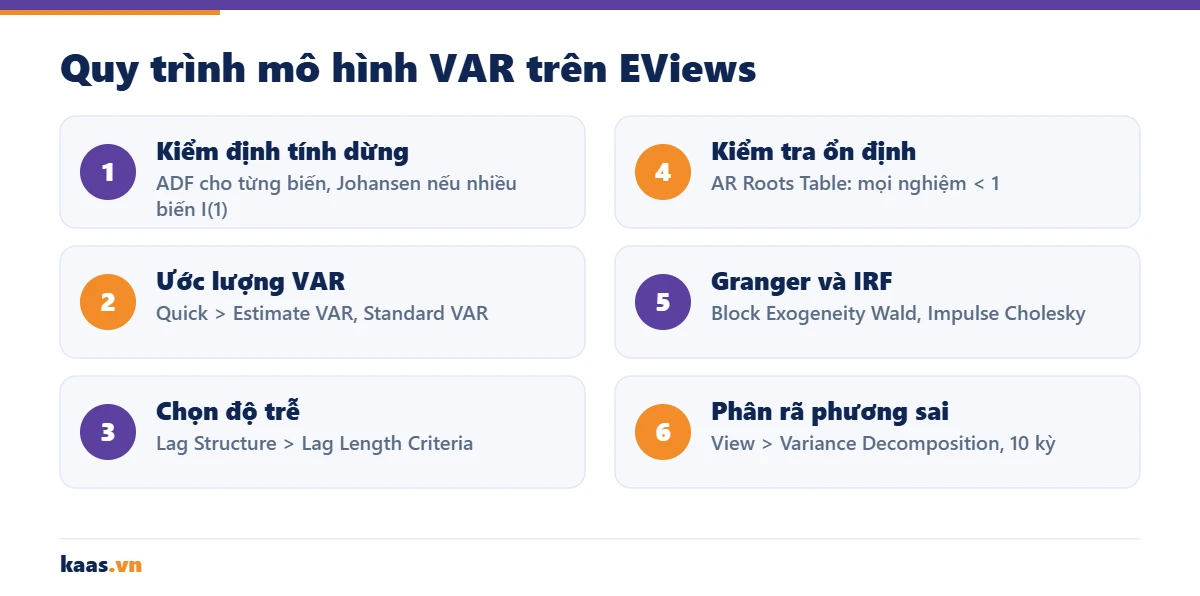
- Mở hộp thoại. Chọn Quick > Estimate VAR... (hoặc Object > New Object > VAR).
- Chọn loại. Ở mục VAR Type chọn Standard VAR.
- Khai báo biến. Endogenous variables gõ
gdpg inf dir; Exogenous variables giữc. - Đặt trễ tạm. Lag Intervals for Endogenous nhập
1 2, bấm OK để có một mô hình VAR ban đầu. - Chọn độ trễ. Trong cửa sổ VAR, chọn View > Lag Structure > Lag Length Criteria, nhập số trễ tối đa 4 với dữ liệu quý.
- Ước lượng lại. Bấm Estimate, sửa Lag Intervals theo độ trễ được chọn.
Cú pháp lệnh tương đương trong EViews 12/13:
series dir = d(ir)
var var1.ls 1 2 gdpg inf dir @ c
var1.laglen(4)
var1.arroots
var1.testexog
Bảng Lag Length Criteria đánh dấu sao độ trễ được chọn theo từng tiêu chí.
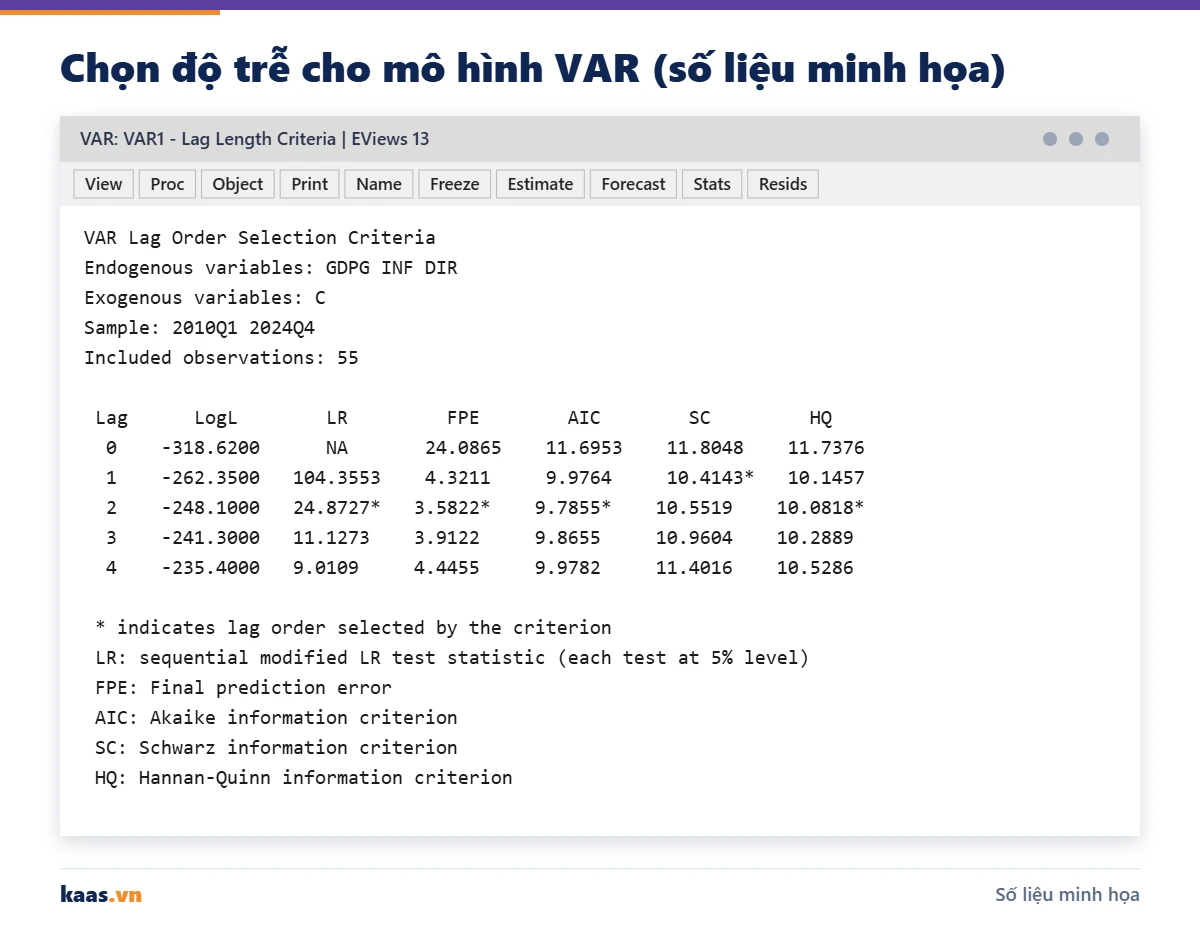
Trong ví dụ (số liệu minh họa), LR, FPE, AIC và HQ cùng chọn 2 trễ, còn SC chọn 1 trễ. SC phạt tham số nặng nên thường chọn mô hình VAR gọn hơn. Theo nguyên tắc đa số và để phần dư sạch tự tương quan, ta chọn VAR(2). Nếu chọn VAR(1) theo SC, hãy kiểm tra tự tương quan phần dư bằng View > Residual Tests > Autocorrelation LM Test; nếu còn tự tương quan, tăng độ trễ.
Mẹo: Mỗi trễ thêm vào mô hình VAR ba biến tốn 9 tham số. Với dữ liệu năm khoảng 30 quan sát, hệ ba biến hiếm khi chịu được quá 2 trễ; hãy ưu tiên ít biến và ít trễ.
Bước 3: Kiểm tra điều kiện ổn định của mô hình VAR
Một mô hình VAR ổn định khi mọi nghiệm của đa thức đặc trưng có mô-đun nhỏ hơn 1, tức nằm trong vòng tròn đơn vị. Chỉ khi đó cú sốc mới tắt dần, IRF hội tụ về 0 và sai số chuẩn của IRF mới hợp lệ. Chọn View > Lag Structure > AR Roots Table hoặc AR Roots Graph.
Mô hình VAR(2) với ba biến có 6 nghiệm. Ví dụ (số liệu minh họa): mô-đun lớn nhất là 0,812 (cặp nghiệm phức 0,543 ± 0,604i), các nghiệm còn lại lần lượt 0,642; 0,411; 0,411 và 0,211. EViews kết luận "No root lies outside the unit circle. VAR satisfies the stability condition." Nếu có nghiệm bằng hoặc gần 1, thường là dấu hiệu còn biến không dừng trong hệ thống.
Bước 4: Kiểm định nhân quả Granger trong mô hình VAR
Theo Granger (1969), trong mô hình VAR, X được gọi là nhân quả Granger của Y nếu các giá trị trễ của X giúp dự báo Y tốt hơn so với chỉ dùng trễ của Y. Trong EViews, chọn View > Lag Structure > Granger Causality/Block Exogeneity Tests. Kết quả là kiểm định Wald \(\chi^2\) cho giả thuyết H0: các hệ số trễ của biến bị loại (Excluded) đồng thời bằng 0.
| Phương trình GDPG, biến bị loại | \(\chi^2\) | df | p | Kết luận (số liệu minh họa) |
|---|---|---|---|---|
| INF | 7,21 | 2 | 0,027 | INF nhân quả Granger tới GDPG |
| DIR | 9,84 | 2 | 0,007 | DIR nhân quả Granger tới GDPG |
| All | 15,32 | 4 | 0,004 | Hai biến cùng giúp dự báo GDPG |
Bậc tự do bằng số trễ của mô hình VAR (ở đây là 2). Dòng All kiểm định đồng thời mọi biến khác, cho biết GDPG có ngoại sinh khối (block exogenous) hay không. Nhân quả Granger chỉ phản ánh quan hệ đi trước về mặt thời gian; khi viết luận văn, nên dùng cụm "nhân quả theo nghĩa Granger" để tránh hiểu nhầm.
Bước 5: Hàm phản ứng xung và thứ tự Cholesky
Hệ số của mô hình VAR rất khó diễn giải trực tiếp vì có quá nhiều tham số và dấu thường đổi theo độ trễ. Hàm phản ứng xung (IRF) giải quyết vấn đề này bằng cách mô phỏng đường phản ứng của từng biến sau một cú sốc bằng một độ lệch chuẩn vào biến khác. Trong cửa sổ VAR, bấm nút Impulse (hoặc View > Impulse Response...).
- Khai báo biến. Thẻ Display: Impulses gõ
gdpg inf dir, Responses gõgdpg inf dir, Periods nhập 10. - Chọn cách trình bày. Display Format chọn Multiple Graphs; Response Standard Errors chọn Analytic hoặc Monte Carlo (ví dụ 1.000 lần lặp).
- Chọn cách nhận dạng. Thẻ Impulse Definition chọn Cholesky - dof adjusted, ô Cholesky Ordering ghi thứ tự
gdpg inf dir.
Vì sao thứ tự biến quan trọng trong mô hình VAR
Phân rã Cholesky giả định biến đứng trước không phản ứng tức thời với cú sốc của biến đứng sau trong cùng kỳ. Thứ tự GDPG, INF, DIR hàm ý ngân hàng trung ương điều chỉnh lãi suất ngay khi quan sát tăng trưởng và lạm phát, còn sản lượng và giá chỉ phản ứng với lãi suất sau ít nhất một quý. Đây là giả định phổ biến trong nghiên cứu chính sách tiền tệ nhưng cần được nêu rõ.
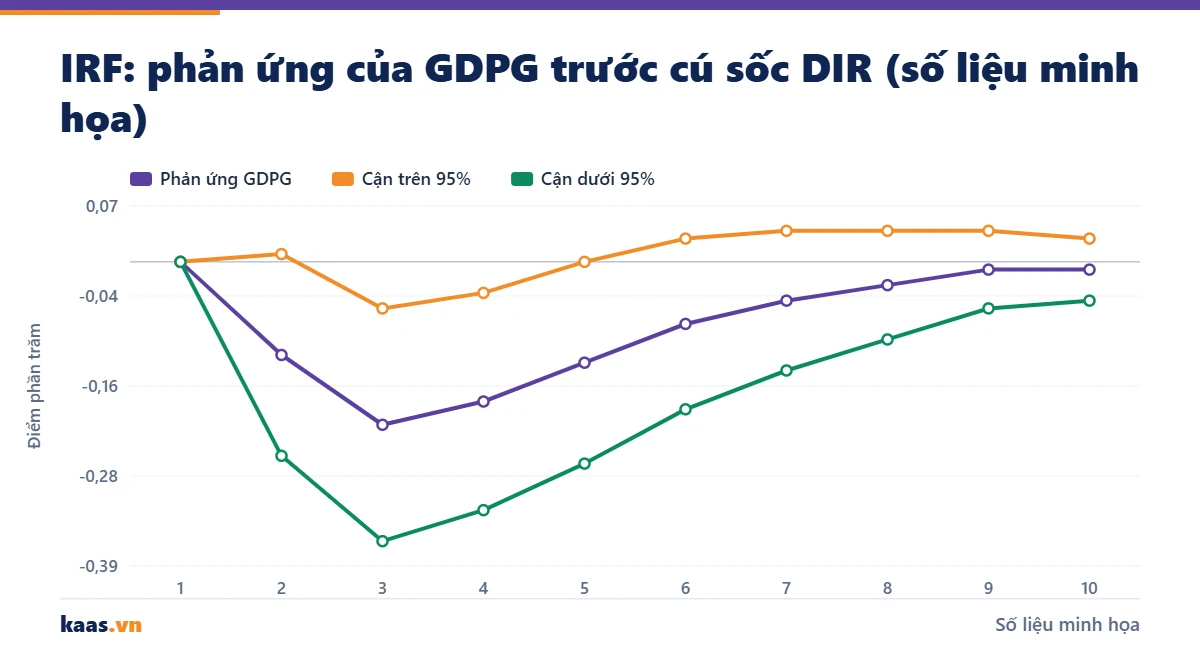
Đồ thị minh họa: GDPG không phản ứng ở quý 1 (đúng giả định Cholesky), giảm mạnh nhất khoảng 0,21 điểm phần trăm ở quý 3 rồi tắt dần về 0 sau khoảng 8 quý. Nếu dải tin cậy chứa 0 ở mọi thời điểm, phản ứng không có ý nghĩa thống kê. Bạn nên thử đổi thứ tự biến; nếu kết luận chính không đổi, kết quả đáng tin cậy hơn.
Bước 6: Phân rã phương sai sai số dự báo
Phân rã phương sai (variance decomposition) của mô hình VAR cho biết mỗi cú sốc đóng góp bao nhiêu phần trăm vào phương sai sai số dự báo của một biến tại từng kỳ. Chọn View > Variance Decomposition..., nhập Periods 10 và giữ thứ tự Cholesky giống IRF.
Ví dụ: Tại kỳ thứ 10 (số liệu minh họa), phương sai sai số dự báo của GDPG được giải thích 78,4% bởi chính cú sốc GDPG, 8,9% bởi INF và 12,7% bởi DIR. Diễn giải: biến động lãi suất có vai trò đáng kể hơn lạm phát trong việc giải thích dao động tăng trưởng ở trung hạn.
Kỳ đầu tiên, biến đứng đầu thứ tự Cholesky luôn được giải thích 100% bởi chính nó; đó là hệ quả kỹ thuật, không phải phát hiện. Hãy tập trung vào xu hướng ở kỳ 4, 8 và 10.
Khi nào chuyển từ mô hình VAR sang VECM
Giả sử bạn làm việc với chuỗi dạng log LNGDP, LNCPI, LNM2 và cả ba đều là I(1). Thay vì lấy sai phân ngay, chạy kiểm định Johansen (1988): trong cửa sổ VAR ước lượng ở dạng mức, chọn View > Cointegration Test..., hoặc mở nhóm biến rồi chọn View > Cointegration Test > Johansen System Cointegration Test. Thường chọn giả định số 3 (hằng số trong phương trình đồng liên kết và trong VAR, không xu thế), Lag intervals (in first differences) bằng số trễ VAR trừ 1.
Kết quả minh họa: thống kê Trace cho giả thuyết None bằng 42,85, lớn hơn giá trị tới hạn 5% là 29,80 (p = 0,001); cho giả thuyết At most 1 bằng 11,20, nhỏ hơn 15,49 (p = 0,199). Thống kê Max-Eigen cho kết luận tương tự. Như vậy có đúng một quan hệ đồng liên kết.
Khi đó ước lượng VECM: Quick > Estimate VAR, VAR Type chọn Vector Error Correction, thẻ Cointegration nhập Rank bằng 1 và chọn cùng giả định xu thế. Hệ số điều chỉnh (CointEq1) của ít nhất một phương trình phải âm và có ý nghĩa. Nếu Johansen không tìm thấy đồng liên kết, quay lại mô hình VAR ở sai phân bậc 1.
Chạy mô hình VAR trên Stata
Stata 17 và 18 có bộ lệnh đầy đủ cho mô hình VAR và VECM. Nếu mới dùng Stata, tham khảo bài phân tích dữ liệu bằng Stata để làm quen.
tsset t
gen dir = D.ir
varsoc gdpg inf dir, maxlag(4)
var gdpg inf dir, lags(1/2)
varstable, graph
varlmar, mlag(4)
vargranger
irf create m1, set(myirf, replace) step(10)
irf graph oirf, impulse(dir) response(gdpg)
irf table fevd, impulse(dir) response(gdpg)
vecrank lngdp lncpi lnm2, trend(constant) lags(2)
Lệnh vecrank là kiểm định Johansen tương đương EViews.
Viết kết quả mô hình VAR theo chuẩn APA
Kết quả mô hình VAR nên trình bày theo trình tự: bảng kiểm định nghiệm đơn vị, bảng chọn độ trễ, kết quả ổn định (bảng hoặc đồ thị AR Roots), bảng Granger, đồ thị IRF có dải tin cậy, bảng phân rã phương sai tại kỳ 1, 4, 8, 10 và kiểm định tự tương quan phần dư. Không cần báo cáo toàn bộ hệ số ước lượng trong thân bài; đưa vào phụ lục.
Câu mẫu (số liệu minh họa): "Mô hình VAR(2) được lựa chọn theo AIC, FPE, HQ và LR; tất cả nghiệm AR nằm trong vòng tròn đơn vị (mô-đun lớn nhất 0,812). Kiểm định Granger cho thấy lãi suất là nhân quả Granger của tăng trưởng, \(\chi^2(2) = 9{,}84\), p = 0,007. Cú sốc tăng lãi suất một độ lệch chuẩn làm tăng trưởng giảm tối đa 0,21 điểm phần trăm sau ba quý."
Lỗi thường gặp khi ước lượng mô hình VAR
- Đưa biến I(1) vào VAR dạng gốc mà không kiểm định đồng liên kết. Cách xử lý: chạy Johansen, chọn VECM hoặc VAR sai phân.
- Quá nhiều biến và trễ. Mô hình mất bậc tự do, IRF có dải tin cậy rất rộng. Cách xử lý: giới hạn 3 đến 4 biến cốt lõi.
- Không biện minh thứ tự Cholesky. Cách xử lý: nêu lý do thứ tự trong phần phương pháp, thử thứ tự khác như kiểm tra độ vững.
- Bỏ qua kiểm tra ổn định. Cách xử lý: luôn báo cáo AR Roots trước khi diễn giải IRF.
- Diễn giải Granger như nhân quả cấu trúc. Cách xử lý: dùng cụm "nhân quả theo nghĩa Granger".
Muốn thực hành với chuỗi vĩ mô thật, xem cách tải chỉ số trong bài dữ liệu World Bank hoặc bài ARIMA trên EViews để làm quen với mô hình chuỗi thời gian đơn biến trước.
Checklist trước khi báo cáo mô hình VAR
- Đã kiểm định nghiệm đơn vị cho mọi biến và ghi rõ bậc tích hợp.
- Đã chạy Johansen nếu có từ hai biến I(1) trở lên.
- Đã chọn độ trễ mô hình VAR theo Lag Length Criteria và ghi tiêu chí.
- Đã kiểm tra AR Roots và tự tương quan phần dư (LM test).
- Đã nêu và biện minh thứ tự Cholesky, báo cáo IRF có dải tin cậy.
- Đã báo cáo Granger và phân rã phương sai ở một số kỳ tiêu biểu.
Câu hỏi thường gặp về mô hình VAR
Mô hình VAR cần bao nhiêu quan sát?
Phụ thuộc số biến và trễ. Mỗi phương trình có \(k \times p + 1\) tham số; nên có ít nhất vài chục quan sát dư sau khi trừ số tham số. Với dữ liệu năm ngắn, ưu tiên VAR 2 đến 3 biến, 1 đến 2 trễ.
Hệ số trong bảng VAR không có ý nghĩa thì sao?
Điều này rất phổ biến do đa cộng tuyến giữa các trễ. Trọng tâm diễn giải là Granger, IRF và phân rã phương sai, không phải từng hệ số riêng lẻ.
Có thể thêm biến ngoại sinh vào VAR không?
Có. Trong mô hình VAR, ghi biến đó vào ô Exogenous variables cùng với c, ví dụ giá dầu thế giới hoặc biến giả 2020. Biến ngoại sinh không có phương trình riêng và không có IRF.
Nên chọn Analytic hay Monte Carlo cho sai số chuẩn IRF?
Analytic tính nhanh dựa trên xấp xỉ tiệm cận. Monte Carlo mô phỏng lặp lại, thường đáng tin hơn với mẫu nhỏ. Hãy ghi rõ lựa chọn và số lần lặp.
Generalized impulse khác gì Cholesky?
Generalized impulse không phụ thuộc thứ tự biến, nhưng các cú sốc không trực giao nên phân rã phương sai không cộng lại đúng 100%. Có thể dùng như kiểm tra độ vững bên cạnh Cholesky.
Cần người hướng dẫn chạy mô hình VAR?
Qua dịch vụ EViews, Kaas.vn hướng dẫn từng bước, giải thích kết quả và bàn giao file để bạn tự chạy lại; chúng tôi không viết thay và không chỉnh số liệu. Bạn có thể luyện tập trước với bộ dữ liệu thực hành chuỗi thời gian.
Tài liệu tham khảo
- Sims, C. A. (1980). Macroeconomics and reality. Econometrica, 48(1), 1-48. doi:10.2307/1912017
- Granger, C. W. J. (1969). Investigating causal relations by econometric models and cross-spectral methods. Econometrica, 37(3), 424-438. doi:10.2307/1912791
- Johansen, S. (1988). Statistical analysis of cointegration vectors. Journal of Economic Dynamics and Control, 12(2-3), 231-254. doi:10.1016/0165-1889(88)90041-3
- Dickey, D. A., & Fuller, W. A. (1979). Distribution of the estimators for autoregressive time series with a unit root. Journal of the American Statistical Association, 74(366a), 427-431. doi:10.1080/01621459.1979.10482531
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage.
Gửi mô hình (ảnh, Word, PDF) và chọn SPSS, AMOS, SmartPLS, Stata, Eviews hoặc R. Kaas.vn đề xuất phương án và báo giá miễn phí.
- RStudio cho người mới: 6 bước phân tích dữ liệu và phân tích tự động với R
- Phân tích định lượng là gì? 9 phương pháp phổ biến và cách chọn đúng
- Hướng dẫn Eviews 10: 7 bước từ nhập dữ liệu đến hồi quy và kiểm định
- Kiểm định phi tham số: 5 phép kiểm định trên SPSS kèm effect size
- Thiết kế bảng hỏi khảo sát: 8 bước chuẩn học thuật và ví dụ chi tiết
Bài viết cùng chủ đề:
-

Mô hình ARDL: 7 bước chạy bounds test và ECM trên EViews
-
Kiểm định ADF: 8 bước kiểm tra tính dừng trên EViews và Stata
-
ARIMA Eviews: 6 bước dự báo chuỗi thời gian theo Box-Jenkins
-

Chạy Eview cho chuỗi thời gian: 8 bước từ kiểm định tính dừng đến ARDL, VECM
-
Hướng dẫn Eviews 10: 7 bước từ nhập dữ liệu đến hồi quy và kiểm định