HTMT (Heterotrait-Monotrait ratio) là tiêu chí đánh giá giá trị phân biệt được khuyến nghị nhiều nhất hiện nay trong mô hình cấu trúc, cả PLS-SEM trên SmartPLS lẫn CB-SEM trên AMOS. Nếu bài báo hoặc luận văn của bạn chỉ dùng tiêu chí Fornell-Larcker, khả năng cao phản biện sẽ yêu cầu bổ sung chỉ số này. Bài viết giải thích HTMT là gì, cách tính, ngưỡng 0,85 và 0,90, 5 bước đánh giá trên SmartPLS 4, cách đọc khoảng tin cậy bootstrap và cách xử lý khi giá trị phân biệt không đạt.
Giá trị phân biệt là gì và vì sao quan trọng?
Giá trị phân biệt (discriminant validity) cho biết một khái niệm có thực sự khác biệt với các khái niệm khác trong mô hình hay không. Ví dụ: "sự hài lòng" và "lòng trung thành" là hai khái niệm có liên quan nhưng phải đo được những điều khác nhau. Nếu các biến quan sát của hai khái niệm này gần như đo cùng một thứ, việc ước lượng tác động của hài lòng lên trung thành sẽ mất ý nghĩa.
Thiếu giá trị phân biệt dẫn đến các hệ quả:
- Hệ số đường dẫn giữa hai khái niệm bị thổi phồng hoặc không ổn định.
- Đa cộng tuyến giữa các biến tiềm ẩn trong mô hình cấu trúc.
- Kết luận về mối quan hệ giữa các khái niệm có thể chỉ phản ánh sự trùng lặp đo lường.
Vì vậy, đánh giá giá trị phân biệt là bước bắt buộc trong đánh giá mô hình đo lường, cùng với độ tin cậy (CR, Cronbach's Alpha) và giá trị hội tụ (AVE).
HTMT là gì?
Henseler, Ringle và Sarstedt (2015) đề xuất HTMT sau khi chứng minh bằng mô phỏng rằng tiêu chí Fornell-Larcker và tiêu chí cross-loading thường không phát hiện được vấn đề giá trị phân biệt, đặc biệt khi các hệ số tải tương đối đồng đều.
Về trực giác, HTMT so sánh hai loại tương quan:
- Tương quan dị biệt (heterotrait): trung bình tương quan giữa các biến quan sát của hai khái niệm khác nhau.
- Tương quan đơn biệt (monotrait): trung bình tương quan giữa các biến quan sát trong cùng một khái niệm.
HTMT của hai khái niệm A và B bằng tương quan dị biệt chia cho trung bình nhân của tương quan đơn biệt của A và của B. Nếu các biến của A tương quan với các biến của B gần bằng mức chúng tương quan với nhau trong nội bộ, tỷ số này tiến gần 1, cho thấy A và B khó phân biệt.
Về mặt lý thuyết, chỉ số này là ước lượng của tương quan thực giữa hai khái niệm nếu chúng được đo hoàn hảo, không có sai số đo lường.
Ngưỡng đánh giá HTMT
| Ngưỡng | Khi nào áp dụng | Nguồn |
|---|---|---|
| < 0,85 (HTMT.85) | Các khái niệm khác biệt rõ về nội dung (ví dụ chất lượng dịch vụ và giá cảm nhận) | Kline (2011); Henseler và cộng sự (2015) |
| < 0,90 (HTMT.90) | Các khái niệm gần nhau về nội dung (ví dụ hài lòng nhận thức và hài lòng cảm xúc) | Gold và cộng sự (2001); Henseler và cộng sự (2015) |
| Khoảng tin cậy không chứa 1 | Kiểm định thống kê (HTMT inference) | Henseler và cộng sự (2015) |
Ngưỡng 0,85 bảo thủ hơn và được nhiều tạp chí ưa chuộng. Khi dùng ngưỡng 0,90, bạn cần lập luận rằng các khái niệm trong mô hình có nội dung gần nhau. Franke và Sarstedt (2019) khuyến nghị kiểm định xem giới hạn trên của khoảng tin cậy có nhỏ hơn ngưỡng đã chọn hay không, thay vì chỉ so sánh với 1.
5 bước đánh giá HTMT trên SmartPLS 4
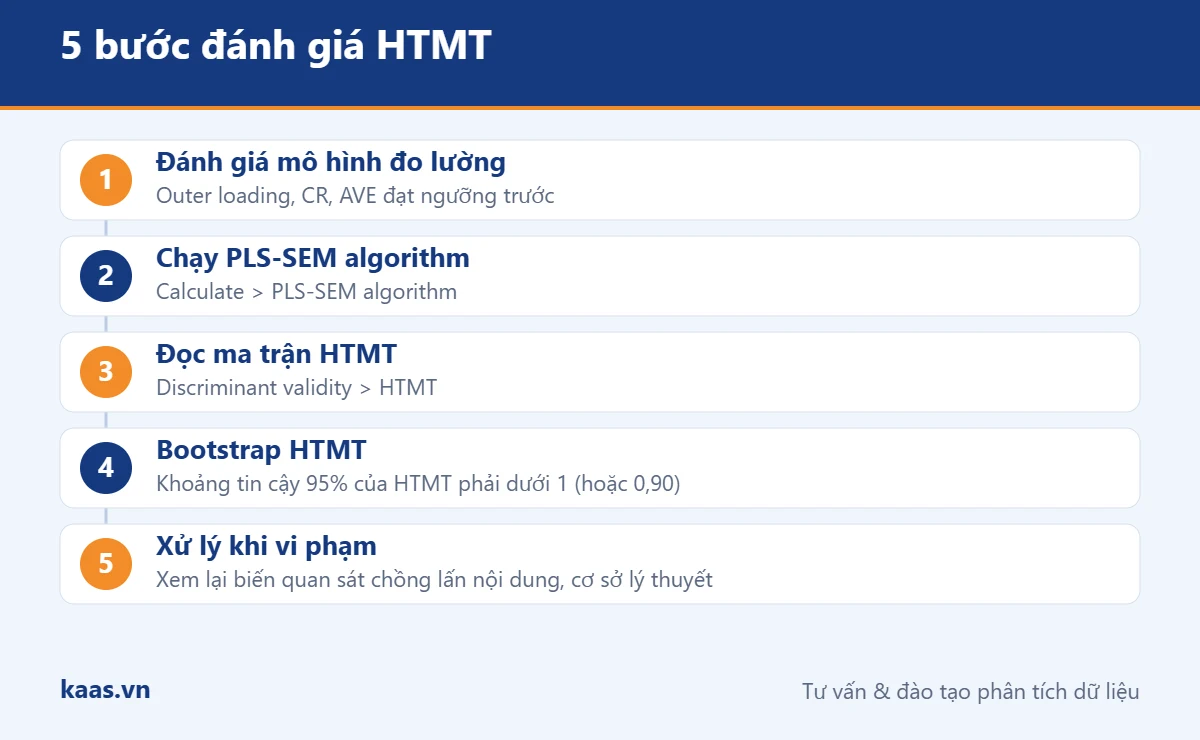
Bước 1: Đánh giá mô hình đo lường trước
Trước khi xem giá trị phân biệt, cần đảm bảo các tiêu chí khác đạt: hệ số tải ngoài (outer loading) từ 0,708, Cronbach's Alpha và CR (rho_c) từ 0,7, AVE từ 0,5. Biến quan sát có hệ số tải thấp có thể ảnh hưởng đến kết quả phân biệt. Xem bài phân tích SmartPLS để biết cách đánh giá các chỉ số này.
Bước 2: Chạy PLS-SEM algorithm
Trong SmartPLS 4, mở mô hình, chọn Calculate > PLS-SEM algorithm. Giữ thiết lập mặc định (Path weighting scheme, 3.000 vòng lặp tối đa) và nhấn Start calculation.
Bước 3: Đọc ma trận HTMT
Trong báo cáo kết quả, vào Quality criteria > Discriminant validity và chọn tab Heterotrait-monotrait ratio (HTMT) - Matrix. Ma trận hiển thị giá trị cho từng cặp khái niệm ở nửa dưới đường chéo. Tab HTMT - List cho dạng danh sách dễ sao chép.
Bước 4: Bootstrap HTMT
Để kiểm định thống kê, chọn Calculate > Bootstrapping, đặt 10.000 subsamples (hoặc tối thiểu 5.000), chọn Percentile bootstrap, kiểm định một phía (one-tailed) với mức ý nghĩa 0,05. Trong kết quả, xem Quality criteria > Heterotrait-monotrait ratio (HTMT) với các cột Original sample, 5% và 95%. Giới hạn trên (cột 95%) cần nhỏ hơn 0,85 hoặc 0,90 tùy ngưỡng đã chọn.
Bước 5: Xử lý khi vi phạm
Nếu một cặp khái niệm có giá trị vượt ngưỡng, xem lại nội dung các biến quan sát và cơ sở lý thuyết trước khi quyết định điều chỉnh. Các cách xử lý được trình bày ở phần sau.
Cách đọc ma trận HTMT
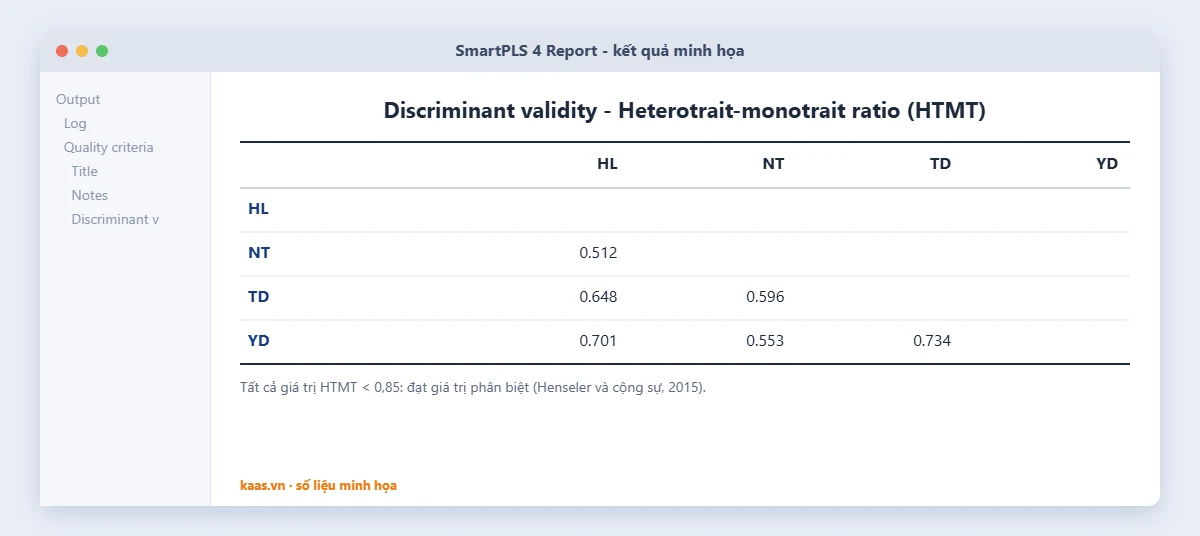
Bảng minh họa trên là ma trận cho mô hình gồm bốn khái niệm: sự hài lòng (HL), niềm tin (NT), thái độ (TD) và ý định (YD), cỡ mẫu 340. Số liệu chỉ mang tính minh họa.
- Giá trị cao nhất là cặp TD và YD = 0,734, vẫn thấp hơn ngưỡng 0,85.
- Cặp NT và HL thấp nhất = 0,512, cho thấy hai khái niệm khác biệt rõ.
- Tất cả giá trị đều dưới 0,85, nên mô hình đạt giá trị phân biệt theo tiêu chí HTMT.
Khi báo cáo, nên kèm bảng khoảng tin cậy bootstrap:
| Cặp khái niệm | Giá trị gốc | Giới hạn 95% | Kết luận |
|---|---|---|---|
| NT ↔ HL | 0,512 | 0,603 | Đạt |
| TD ↔ HL | 0,648 | 0,731 | Đạt |
| TD ↔ NT | 0,596 | 0,684 | Đạt |
| YD ↔ HL | 0,701 | 0,779 | Đạt |
| YD ↔ NT | 0,553 | 0,642 | Đạt |
| YD ↔ TD | 0,734 | 0,812 | Đạt |
Ghi chú: số liệu minh họa, bootstrap 10.000 mẫu, giới hạn trên của khoảng tin cậy một phía 95%.
So sánh HTMT với Fornell-Larcker và cross-loading
| Tiêu chí | Cách đánh giá | Ưu điểm | Hạn chế |
|---|---|---|---|
| Fornell-Larcker | Căn bậc hai AVE lớn hơn tương quan với khái niệm khác | Quen thuộc, dễ tính | Kém nhạy, thường bỏ sót vấn đề |
| Cross-loading | Biến tải lên khái niệm của mình cao hơn khái niệm khác | Phát hiện biến "lạc chỗ" | Rất kém nhạy ở cấp khái niệm |
| HTMT | Tỷ số dị biệt - đơn biệt dưới ngưỡng | Nhạy, có kiểm định thống kê | Cần lập luận khi chọn ngưỡng |
Cách báo cáo phổ biến hiện nay là trình bày HTMT làm tiêu chí chính, có thể kèm Fornell-Larcker để đối chiếu với các nghiên cứu trước. Không nên chỉ dựa vào Fornell-Larcker.
Xử lý khi giá trị phân biệt không đạt
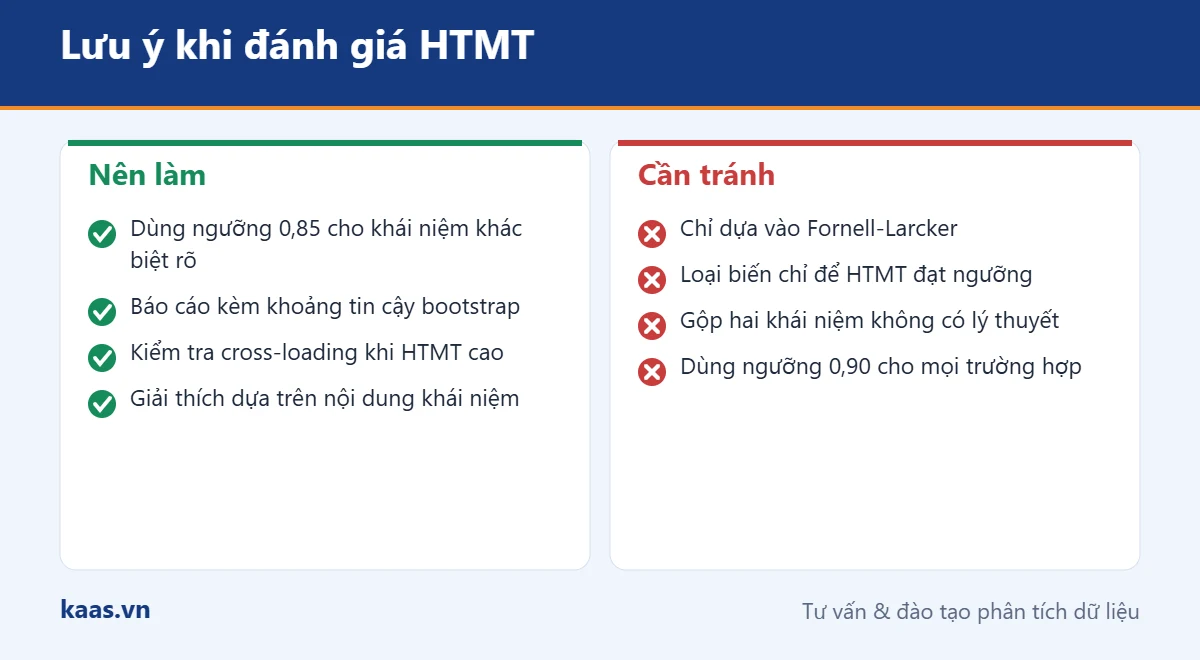
Xem lại nội dung biến quan sát
Đọc lại từng câu hỏi của hai khái niệm có giá trị cao. Thường sẽ có một hoặc hai câu có nội dung chồng lấn, ví dụ câu "Tôi sẽ giới thiệu dịch vụ cho bạn bè" xuất hiện trong thang đo hài lòng nhưng thực chất đo ý định truyền miệng.
Kiểm tra cross-loading của từng biến
Biến có hệ số tải chéo cao lên khái niệm khác là ứng viên cần xem xét. Loại biến chỉ khi có lý do nội dung và vẫn đảm bảo khái niệm được đo đầy đủ.
Cân nhắc gộp khái niệm
Nếu hai khái niệm có nền tảng lý thuyết cho thấy chúng là hai khía cạnh của cùng một khái niệm bậc cao, có thể xây dựng khái niệm bậc hai. Quyết định này phải dựa trên lý thuyết, không chỉ để chỉ số đạt.
Báo cáo trung thực
Nếu không có cơ sở để điều chỉnh, hãy báo cáo kết quả kèm thảo luận về hạn chế. Che giấu vấn đề giá trị phân biệt là vi phạm tính minh bạch của nghiên cứu.
Nguyên nhân phổ biến khiến giá trị phân biệt thấp
Trong thực tế hướng dẫn luận văn, các vấn đề về giá trị phân biệt thường xuất phát từ khâu thiết kế bảng hỏi chứ không phải từ khâu phân tích. Một số nguyên nhân hay gặp:
- Dịch thang đo chưa sát: hai câu tiếng Anh khác nhau về sắc thái nhưng khi dịch sang tiếng Việt lại gần như giống nhau.
- Đặt các khái niệm liên tiếp nhau: người trả lời có xu hướng chọn cùng mức điểm cho các câu nằm cạnh nhau, làm tăng tương quan giữa các khái niệm.
- Mô hình có khái niệm quá gần nhau: ví dụ vừa có "hài lòng" vừa có "thích thú", vừa có "ý định sử dụng" vừa có "ý định tiếp tục sử dụng".
- Sai lệch phương pháp chung: toàn bộ biến được đo bằng một bảng hỏi, một thời điểm, cùng thang Likert.
- Mẫu thiếu đa dạng: khi phần lớn người trả lời có cùng đặc điểm, khác biệt giữa các khái niệm khó thể hiện.
Phòng ngừa ngay từ đầu bằng cách thử nghiệm bảng hỏi (pilot test), kiểm tra bản dịch ngược (back-translation) và sắp xếp câu hỏi hợp lý sẽ hiệu quả hơn nhiều so với việc xử lý sau khi đã thu dữ liệu. Xem thêm bài thiết kế bảng hỏi.
Ví dụ thực hành: mô hình chấp nhận ngân hàng số
Một đề tài khảo sát 410 khách hàng (số liệu minh họa) về ý định sử dụng ngân hàng số, gồm năm khái niệm: nhận thức hữu ích, nhận thức dễ sử dụng, niềm tin, rủi ro cảm nhận và ý định sử dụng.
Lần chạy đầu, cặp nhận thức hữu ích và ý định sử dụng có tỷ số 0,912, vượt cả ngưỡng 0,90. Xem cross-loading, câu HI4 "Ngân hàng số giúp tôi muốn giao dịch thường xuyên hơn" có hệ số tải lên ý định sử dụng (0,79) gần bằng hệ số tải lên khái niệm gốc (0,81).
Đọc lại nội dung, câu HI4 thực chất mang nghĩa ý định hành vi, không phải đánh giá về lợi ích. Sau khi loại câu này với lý do nội dung rõ ràng, tỷ số giảm xuống 0,836, giới hạn trên khoảng tin cậy là 0,881. Khái niệm nhận thức hữu ích vẫn còn bốn biến quan sát, AVE tăng từ 0,58 lên 0,63.
Toàn bộ quá trình được ghi lại trong luận văn: giá trị trước và sau khi điều chỉnh, lý do loại câu HI4, và lưu ý rằng ngưỡng 0,90 được sử dụng vì hai khái niệm có liên hệ chặt chẽ trong mô hình TAM. Cách báo cáo minh bạch như vậy giúp hội đồng đánh giá được tính hợp lý của quyết định.
Tính HTMT trên AMOS và R
Chỉ số này không chỉ dành cho PLS-SEM. Với CB-SEM:
- AMOS: dùng plugin HTMT của Gaskin hoặc tính bằng file Excel từ ma trận tương quan các biến quan sát. Xem bài phân tích CFA trên AMOS.
- R: hàm
htmt()trong gói semTools:semTools::htmt(mo_hinh, data = du_lieu).
Lưu ý rằng SmartPLS 4 mặc định dùng phiên bản HTMT2 (dựa trên trung bình nhân), được Roemer và cộng sự (2021) đề xuất để khắc phục chệch khi hệ số tải không đồng đều. Khi so sánh kết quả giữa các phần mềm, cần biết phiên bản nào đang được dùng.
Giá trị phân biệt và cỡ mẫu
Với mẫu nhỏ, khoảng tin cậy bootstrap rộng hơn, nên giới hạn trên dễ vượt ngưỡng dù giá trị gốc thấp. Ngược lại, mẫu lớn cho khoảng tin cậy hẹp và kết luận ổn định hơn. Nếu kết quả nằm sát ngưỡng, bạn nên báo cáo cả giá trị gốc lẫn khoảng tin cậy và thảo luận thận trọng thay vì chỉ kết luận đạt hoặc không đạt.
Cách trình bày HTMT trong luận văn
Ví dụ đoạn diễn giải (số liệu minh họa):
Giá trị phân biệt được đánh giá bằng tỷ số HTMT (Henseler và cộng sự, 2015). Tất cả các giá trị nằm trong khoảng 0,51 đến 0,73, thấp hơn ngưỡng 0,85.
Kết quả bootstrap với 10.000 mẫu cho thấy giới hạn trên của khoảng tin cậy 95% đều nhỏ hơn 0,85. Như vậy, các khái niệm trong mô hình đạt giá trị phân biệt.
Bảng trình bày nên có ma trận ở nửa dưới đường chéo, kèm chú thích về ngưỡng sử dụng và nguồn trích dẫn.
Checklist trước khi nộp kết quả HTMT
- Đã đánh giá hệ số tải, CR, AVE trước khi xét giá trị phân biệt.
- Đã nêu rõ ngưỡng sử dụng (0,85 hoặc 0,90) và lý do.
- Có bảng ma trận và bảng khoảng tin cậy bootstrap.
- Đã kiểm tra cross-loading khi có giá trị cao.
- Mọi điều chỉnh thang đo đều có lý do nội dung và được báo cáo.
- Có trích dẫn Henseler và cộng sự (2015).
Câu hỏi thường gặp về HTMT
Giá trị 0,87 có chấp nhận được không?
Vượt ngưỡng 0,85 nhưng dưới 0,90. Nếu hai khái niệm gần nhau về nội dung và bạn có lập luận phù hợp, có thể chấp nhận theo ngưỡng 0,90. Nếu không, cần xem lại thang đo.
Fornell-Larcker đạt nhưng HTMT không đạt thì sao?
Ưu tiên kết luận theo HTMT vì tiêu chí này nhạy hơn. Đây chính là tình huống mà Henseler và cộng sự (2015) cảnh báo.
HTMT có áp dụng cho khái niệm đo bằng một biến không?
Không tính được tương quan đơn biệt khi khái niệm chỉ có một biến quan sát, nên chỉ số không được xác định cho các cặp liên quan đến khái niệm đó.
Có cần báo cáo HTMT cho khái niệm đo lường dạng cấu tạo (formative) không?
Không. Chỉ số này áp dụng cho khái niệm đo lường dạng phản ánh (reflective). Khái niệm dạng cấu tạo được đánh giá bằng VIF, trọng số ngoài và giá trị hội tụ qua phân tích dư thừa.
Cần hướng dẫn đánh giá mô hình đo lường trên SmartPLS?
Kaas.vn hướng dẫn đánh giá độ tin cậy, giá trị hội tụ, giá trị phân biệt và giải thích từng chỉ số; bạn nhận file dự án để tự chạy lại. Xem dịch vụ SmartPLS hoặc gọi 0947 971 630 (Zalo).
Tài liệu tham khảo
- Franke, G., & Sarstedt, M. (2019). Heuristics versus statistics in discriminant validity testing. Internet Research, 29(3), 430-447.
- Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A Primer on Partial Least Squares Structural Equation Modeling (PLS-SEM) (3rd ed.). SAGE.
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115-135. doi:10.1007/s11747-014-0403-8
- Roemer, E., Schuberth, F., & Henseler, J. (2021). HTMT2: An improved criterion for assessing discriminant validity in structural equation modeling. Industrial Management & Data Systems, 121(12), 2637-2650.
- HTMT: 5 bước đánh giá giá trị phân biệt trên SmartPLS và AMOS
- Hỗ trợ chạy Stata: 6 bước phân tích dữ liệu bảng, hồi quy và kiểm định
- Phân tích định lượng là gì? 9 phương pháp phổ biến và cách chọn đúng
- Phân tích độ tin cậy Cronbach's Alpha trong SPSS
- Dịch vụ xử lý định lượng: 8 nội dung phân tích SPSS, AMOS, SmartPLS, Stata, Eviews, R
Bài viết cùng chủ đề:
-

Dịch vụ phân tích dữ liệu nghiên cứu: quy trình 6 bước minh bạch, tái lập được
-
Thiết kế bảng hỏi khảo sát: 8 bước chuẩn học thuật và ví dụ chi tiết
-
Cách tính cỡ mẫu nghiên cứu: 6 công thức thông dụng và ví dụ chi tiết
-

Trắc lượng thư mục với VOSviewer: 7 bước từ tìm kiếm đến bản đồ tri thức
-

RStudio cho người mới: 6 bước phân tích dữ liệu và phân tích tự động với R
-

Phân tích định lượng là gì? 9 phương pháp phổ biến và cách chọn đúng
-

Dịch vụ chạy định lượng tại Kaas.vn: 6 bước minh bạch, chuẩn học thuật
-
Dịch vụ xử lý định lượng: 8 nội dung phân tích SPSS, AMOS, SmartPLS, Stata, Eviews, R
-
Dịch vụ khảo sát nghiên cứu: 7 bước thu thập dữ liệu thật, minh bạch
-

Hỗ trợ chạy Stata: 6 bước phân tích dữ liệu bảng, hồi quy và kiểm định
-
Phân tích SmartPLS 4: 8 bước PLS-SEM từ mô hình đo lường đến trung gian, điều tiết
-

Phân tích độ tin cậy Cronbach's Alpha trong SPSS
-

Hướng dẫn Eviews 10: 7 bước từ nhập dữ liệu đến hồi quy và kiểm định
-

Thang đo thống kê: Bí kíp phân loại trong 3 giây
-

Thuật ngữ thống kê: 20 khái niệm cần biết khi làm nghiên cứu
-
Thống kê mô tả SPSS: 7 bước chạy và đọc kết quả trung bình, độ lệch chuẩn