Đa cộng tuyến là hiện tượng các biến độc lập trong mô hình hồi quy có tương quan mạnh với nhau, khiến mô hình khó tách riêng tác động của từng biến. Khi đó hệ số hồi quy trở nên bất ổn, sai số chuẩn phình to và có thể đổi dấu so với lý thuyết. Đây là một trong những câu hỏi hội đồng hay đặt ra nhất khi bạn trình bày kết quả hồi quy.
Bài viết giải thích bản chất và nguyên nhân, cách phát hiện bằng VIF, Tolerance, Condition Index trên SPSS và Stata, ngưỡng đánh giá theo từng nhóm tác giả, các cách xử lý hợp lệ (gộp biến, centering cho biến tương tác, ridge) và cách viết phần kiểm tra này trong luận văn.
Điểm chính của bài
- Đa cộng tuyến làm tăng sai số chuẩn, không làm sai lệch dự báo tổng thể của mô hình.
- Chỉ số chính là VIF (\(VIF = 1/Tolerance\)); ngưỡng cổ điển là 10, ngưỡng chặt hơn là 5, với PLS-SEM thường dùng 3.
- Trên SPSS tích Collinearity diagnostics trong hộp Statistics của hồi quy tuyến tính; trên Stata dùng
estat vifsauregress. - Xử lý dựa trên lý thuyết: gộp hoặc bỏ biến trùng khái niệm, centering khi có biến tương tác, ridge khi cần giữ mọi biến.
- Không được xóa biến chỉ để "đẹp số"; mọi thay đổi mô hình phải được nêu rõ trong luận văn.
Nội dung bài viết
- Đa cộng tuyến là gì?
- Hậu quả và nguyên nhân của đa cộng tuyến
- Chỉ số phát hiện đa cộng tuyến và ngưỡng đánh giá
- Kiểm tra đa cộng tuyến trên SPSS
- Ví dụ đọc kết quả đa cộng tuyến (số liệu minh họa)
- Kiểm tra đa cộng tuyến trên Stata
- Cách xử lý đa cộng tuyến
- Đa cộng tuyến trong SEM và PLS-SEM
- Viết kết quả kiểm định đa cộng tuyến trong luận văn
- Lỗi thường gặp và checklist
- Câu hỏi thường gặp về đa cộng tuyến
- Tài liệu tham khảo
Đa cộng tuyến là gì?
Trong hồi quy bội, mỗi hệ số \(\beta_j\) đo tác động của \(X_j\) lên \(Y\) khi giữ các biến khác không đổi. Nếu \(X_j\) gần như được "giải thích" hoàn toàn bởi các biến độc lập còn lại, dữ liệu không đủ thông tin để tách tác động riêng của nó. Đó là đa cộng tuyến.
Về mặt toán học, phương sai của hệ số ước lượng bị nhân lên theo hệ số phóng đại phương sai (Variance Inflation Factor):
Trong đó \(R_j^2\) là hệ số xác định khi hồi quy \(X_j\) theo tất cả biến độc lập còn lại. Tolerance là nghịch đảo: \(Tolerance_j = 1 - R_j^2\). Ví dụ \(R_j^2 = 0{,}90\) cho \(VIF = 10\), nghĩa là phương sai của \(\hat\beta_j\) lớn gấp 10 lần so với khi \(X_j\) không tương quan với biến nào, và sai số chuẩn lớn gấp khoảng 3,16 lần.
Đa cộng tuyến hoàn hảo và không hoàn hảo
Đa cộng tuyến hoàn hảo xảy ra khi một biến là tổ hợp tuyến tính chính xác của biến khác, ví dụ đưa cả biến "tổng điểm" và tất cả các điểm thành phần, hoặc đưa đủ mọi nhóm của biến giả (bẫy biến giả). SPSS sẽ tự loại một biến và báo trong bảng Excluded Variables, Stata báo "omitted because of collinearity". Đa cộng tuyến không hoàn hảo (tương quan cao nhưng chưa tuyệt đối) mới là trường hợp thường gặp và cần chẩn đoán.
Hậu quả và nguyên nhân của đa cộng tuyến
Theo Wooldridge (2020), đa cộng tuyến không vi phạm giả định Gauss-Markov nên ước lượng OLS vẫn không chệch. Vấn đề nằm ở độ chính xác:
- Sai số chuẩn lớn, giá trị \(t\) nhỏ, biến quan trọng về lý thuyết có thể không có ý nghĩa thống kê.
- \(R^2\) và kiểm định F tổng thể cao, nhưng ít biến riêng lẻ có ý nghĩa.
- Hệ số nhạy cảm: thêm hoặc bớt vài quan sát làm hệ số thay đổi mạnh, thậm chí đổi dấu.
- Khả năng dự báo của cả mô hình gần như không bị ảnh hưởng.
Những nguyên nhân phổ biến trong luận văn tại Việt Nam:
- Hai thang đo đo các khái niệm quá gần nhau, ví dụ "sự hài lòng" và "niềm tin", hoặc tách một khái niệm thành hai biến.
- Mô hình có biến tương tác \(X \times Z\) hoặc biến bình phương \(X^2\) mà không chuẩn hóa trước.
- Bẫy biến giả, hoặc vừa đưa tổng vừa đưa thành phần.
- Dữ liệu vĩ mô có cùng xu hướng thời gian như GDP, tổng vốn, dân số.
- Mẫu nhỏ so với số biến độc lập.
Chỉ số phát hiện đa cộng tuyến và ngưỡng đánh giá
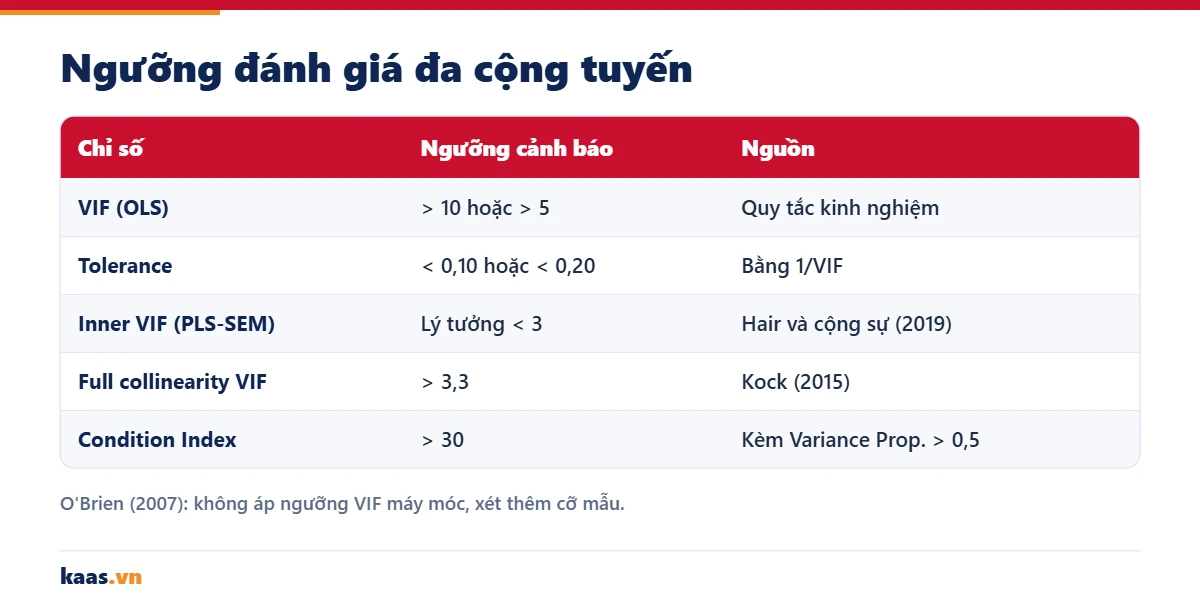
Không có một con số "chuẩn" duy nhất. Bảng dưới tổng hợp các chỉ số và ngưỡng thường dùng, kèm nguồn để bạn trích dẫn đúng.
| Chỉ số | Ngưỡng cảnh báo | Ghi chú, nguồn |
|---|---|---|
| VIF (hồi quy OLS) | > 10 (cổ điển), > 5 (chặt hơn) | Quy tắc kinh nghiệm phổ biến; O'Brien (2007) khuyên không áp máy móc |
| Tolerance | < 0,10 (hoặc < 0,20) | Tương đương VIF > 10 (hoặc > 5) |
| VIF trong PLS-SEM | Lý tưởng < 3; > 5 là vấn đề | Hair và cộng sự (2019) |
| Full collinearity VIF | > 3,3 | Kock (2015), dùng cho cả kiểm tra common method bias |
| Condition Index | > 30 kèm 2 biến có Variance Proportion > 0,5 | Chẩn đoán theo Belsley, đọc trong bảng Collinearity Diagnostics |
| Tương quan cặp | \(|r| > 0{,}8\) | Chỉ là dấu hiệu sơ bộ, không thay VIF |
Ngưỡng VIF khi đánh giá đa cộng tuyến: nên chọn 10, 5 hay 3?
O'Brien (2007) chỉ ra rằng VIF phải được đặt cạnh cỡ mẫu và phương sai của biến: một VIF bằng 8 trong mẫu 2.000 quan sát có thể ít đáng lo hơn VIF bằng 3 trong mẫu 80 quan sát (O'Brien, 2007). Vì vậy hãy chọn ngưỡng theo lĩnh vực và loại mô hình, nêu rõ nguồn, rồi xem thêm sai số chuẩn và độ ổn định của hệ số.
Với nghiên cứu khảo sát dùng hồi quy OLS, nhiều giảng viên chấp nhận VIF dưới 10 nhưng khuyến khích dưới 5. Với PLS-SEM, hãy theo Hair và cộng sự (2019). Quan trọng nhất: chọn ngưỡng trước khi phân tích và giữ nhất quán.
Tương quan cặp chỉ là dấu hiệu sơ bộ: ba biến có thể cùng tạo ra đa cộng tuyến dù từng cặp chỉ tương quan khoảng 0,6. Bạn nên xem ma trận tương quan Pearson trước, rồi kết luận bằng VIF.
Kiểm tra đa cộng tuyến trên SPSS
Đa cộng tuyến được chẩn đoán ngay trong thủ tục hồi quy tuyến tính, không cần chạy riêng. Quy trình đầy đủ của hồi quy xem trong bài hồi quy tuyến tính bội SPSS.
- Mở hộp thoại. Chọn Analyze > Regression > Linear.
- Khai báo biến. Đưa biến phụ thuộc vào Dependent, các biến độc lập vào Independent(s), Method để Enter.
- Bật chẩn đoán. Bấm Statistics, tích Estimates, Model fit và Collinearity diagnostics, bấm Continue.
- Chạy và đọc. Bấm OK. Xem hai cột Tolerance và VIF ở cuối bảng Coefficients, sau đó xem bảng Collinearity Diagnostics.
REGRESSION
  /STATISTICS COEFF OUTS R ANOVA COLLIN TOL
  /DEPENDENT ydinh
  /METHOD=ENTER chatluong giaca hailong niemtin.
Trong bảng Collinearity Diagnostics, mỗi dòng là một chiều (dimension) với Eigenvalue, Condition Index và Variance Proportions. Hãy tìm dòng có Condition Index lớn nhất; nếu ở dòng đó có từ hai biến trở lên có Variance Proportion trên 0,5 thì các biến ấy đang cộng tuyến với nhau.
Mẹo: Với biến thang Likert chưa trừ trung bình, hằng số thường "dính" vào một dimension có Condition Index cao. Nếu chỉ hằng số và một biến có Variance Proportion lớn, đó thường không phải đa cộng tuyến giữa các biến độc lập.
Ví dụ đọc kết quả đa cộng tuyến (số liệu minh họa)
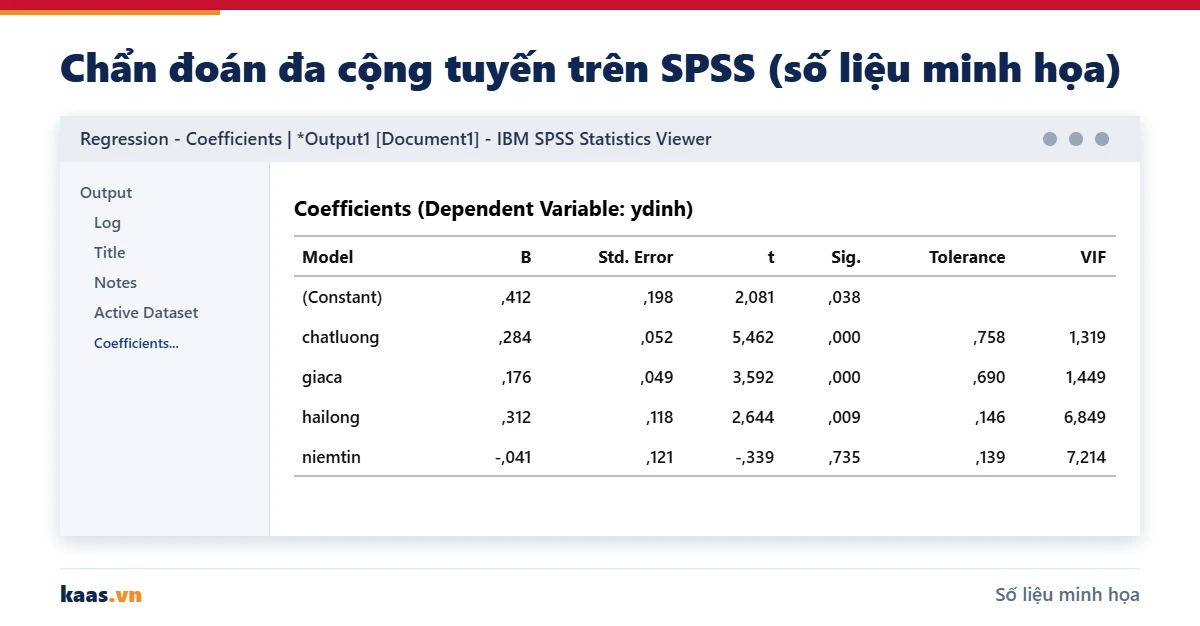
Một học viên khảo sát 250 khách hàng, hồi quy ý định mua lại theo bốn biến: chất lượng sản phẩm, giá cả cảm nhận, sự hài lòng và niềm tin. Mô hình có \(R^2 = 0{,}52\), kiểm định F có ý nghĩa, nhưng niềm tin lại có hệ số âm và không có ý nghĩa, trái với lý thuyết.
| Biến | B | SE | t | Sig. | Tolerance | VIF |
|---|---|---|---|---|---|---|
| Chất lượng sản phẩm | 0,284 | 0,052 | 5,46 | < 0,001 | 0,758 | 1,32 |
| Giá cả cảm nhận | 0,176 | 0,049 | 3,59 | < 0,001 | 0,690 | 1,45 |
| Sự hài lòng | 0,312 | 0,118 | 2,64 | 0,009 | 0,146 | 6,85 |
| Niềm tin | -0,041 | 0,121 | -0,34 | 0,735 | 0,139 | 7,21 |
Hai biến sự hài lòng và niềm tin có VIF lần lượt 6,85 và 7,21, tương quan cặp \(r = 0{,}91\). Theo ngưỡng 10 thì chưa "vi phạm", nhưng theo ngưỡng 5 thì có dấu hiệu đa cộng tuyến, và dấu hiệu thực tế (hệ số đổi dấu, sai số chuẩn gấp đôi các biến khác) xác nhận điều đó. Bảng Collinearity Diagnostics cho dimension cuối có Condition Index 32,4 với Variance Proportion của hai biến này là 0,78 và 0,81.
Ví dụ: Sau khi xem lại thang đo, học viên nhận thấy hai khái niệm không đạt giá trị phân biệt (HTMT 0,94). Gộp thành một nhân tố "gắn kết khách hàng" có cơ sở lý thuyết, VIF mới đều dưới 2 và hệ số mang dấu dương có ý nghĩa (số liệu minh họa).
Kiểm tra đa cộng tuyến trên Stata
Trên Stata 17-18, chạy hồi quy rồi dùng lệnh hậu ước lượng estat vif. Lệnh in VIF và 1/VIF (chính là Tolerance) cho từng biến, kèm Mean VIF.
regress ydinh chatluong giaca hailong niemtin
estat vif
pwcorr chatluong giaca hailong niemtin, sig
Nếu mô hình không có hằng số, thêm tùy chọn estat vif, uncentered. Với dữ liệu bảng, estat vif không chạy sau xtreg; cách thường dùng là chạy regress với cùng biến (hoặc thêm biến giả thời gian) để lấy VIF tham khảo. Xem thêm các thao tác cơ bản trong bài phân tích dữ liệu bảng Stata.
Cách xử lý đa cộng tuyến
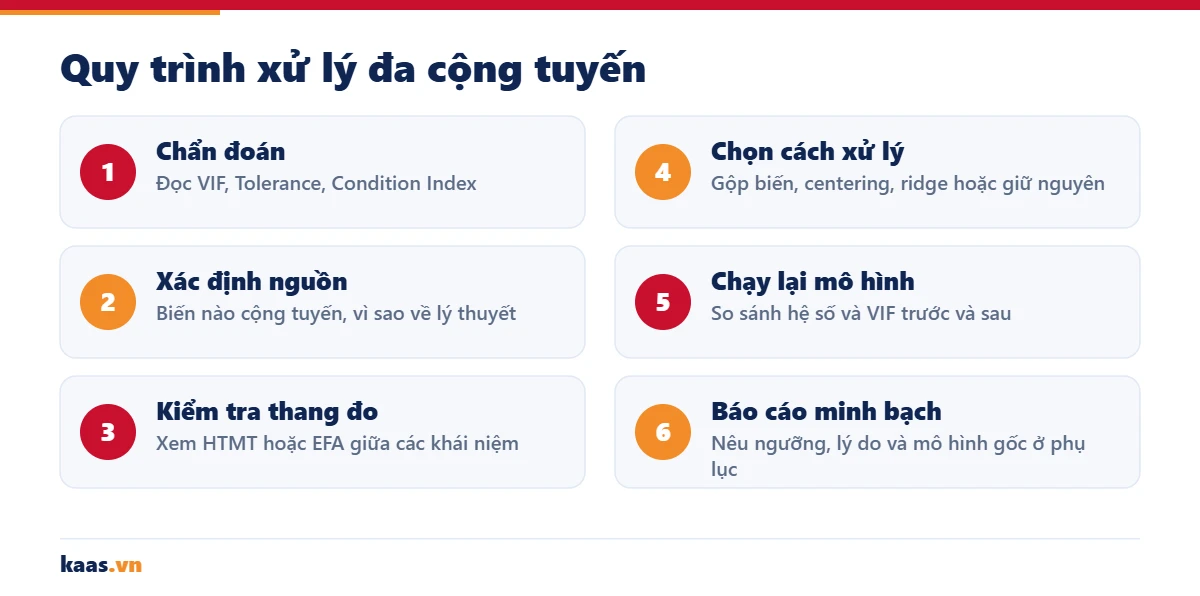
Không có cách xử lý "một cho tất cả". Hãy bắt đầu bằng câu hỏi: biến nào đang cộng tuyến, và vì sao về mặt lý thuyết.
Gộp hoặc loại biến trùng khái niệm
Nếu hai biến đo cùng một khái niệm, hãy kiểm tra lại giá trị phân biệt bằng HTMT hoặc EFA. Khi có cơ sở, gộp thành một nhân tố hoặc giữ biến phù hợp với câu hỏi nghiên cứu. Mọi thay đổi phải được ghi rõ trong chương phương pháp và chương kết quả.
Centering khi có biến tương tác để giảm đa cộng tuyến
Biến tương tác \(X \times Z\) gần như luôn tương quan mạnh với \(X\) và \(Z\). Trừ trung bình trước khi nhân sẽ giảm đa cộng tuyến "không bản chất" này:
summarize hailong, meanonly
generate hailong_c = hailong - r(mean)
summarize thunhap, meanonly
generate thunhap_c = thunhap - r(mean)
generate tuongtac = hailong_c * thunhap_c
Trên SPSS, lấy trung bình bằng Analyze > Descriptive Statistics > Descriptives, rồi tạo biến mới bằng Transform > Compute Variable. Centering không đổi kiểm định của số hạng tương tác, chỉ giúp hệ số chính dễ diễn giải hơn. Chi tiết xem bài biến điều tiết.
Ridge regression và các cách khác
- Ridge regression: chấp nhận một chút chệch để giảm mạnh phương sai. Stata 16 trở lên dùng
elasticnet linear y x1 x2 x3, alpha(0); SPSS có tùy chọn Regularization trong Analyze > Regression > Optimal Scaling (CATREG). - Tăng cỡ mẫu: sai số chuẩn giảm, bù lại phần phóng đại do VIF.
- Không làm gì: hợp lý khi đa cộng tuyến chỉ nằm giữa các biến kiểm soát, hoặc khi mục tiêu là dự báo.
Lưu ý: Loại biến chỉ vì VIF cao mà không có lý do lý thuyết có thể gây thiếu biến (omitted variable bias), một vấn đề nghiêm trọng hơn đa cộng tuyến. Báo cáo cả mô hình trước và sau khi điều chỉnh để người đọc tự đánh giá.
Đa cộng tuyến trong SEM và PLS-SEM
Trong PLS-SEM, SmartPLS 4 báo VIF ở hai nơi: Outer VIF (giữa các biến quan sát, quan trọng với thang đo cấu tạo) và Inner VIF (giữa các biến tiềm ẩn dự báo cùng một biến). Hair và cộng sự (2019) khuyến nghị VIF lý tưởng dưới 3 (Hair et al., 2019). Quy trình cụ thể xem bài PLS-SEM trên SmartPLS.
Kock (2015) còn dùng full collinearity VIF với ngưỡng 3,3 để phát hiện sai lệch phương pháp chung; xem bài common method bias. Trong CB-SEM trên AMOS, tương quan giữa hai biến tiềm ẩn quá cao (trên 0,85) là dấu hiệu tương tự, cần kiểm tra giá trị phân biệt.
Viết kết quả kiểm định đa cộng tuyến trong luận văn
Phần kiểm tra đa cộng tuyến thường nằm trong mục kiểm định giả định hồi quy, cùng với kiểm tra phương sai thay đổi, phân phối chuẩn của phần dư và tự tương quan. Mẫu câu (số liệu minh họa):
"Hệ số phóng đại phương sai (VIF) của các biến độc lập dao động từ 1,32 đến 1,87, Tolerance từ 0,535 đến 0,758, đều thấp hơn ngưỡng 5 được chọn trước. Do đó hiện tượng đa cộng tuyến không đáng kể và không ảnh hưởng đến việc diễn giải hệ số hồi quy (O'Brien, 2007)."
Nếu bạn đã gộp hoặc loại biến, nêu rõ lý do, ngưỡng đã dùng và đưa kết quả mô hình gốc vào phụ lục. Cách sắp xếp mục này trong chương kết quả được trình bày ở bài chương 4 luận văn.
Lỗi thường gặp và checklist
- Chỉ xem ma trận tương quan. Tương quan cặp thấp không loại trừ đa cộng tuyến giữa nhiều biến.
- Trích dẫn ngưỡng sai nguồn. Ngưỡng 3 của PLS-SEM không áp cho OLS và ngược lại; nêu rõ tác giả.
- Quên centering khi có biến tương tác. VIF của số hạng tương tác lên 20, 30 là chuyện thường nếu không trừ trung bình.
- Bỏ biến lặng lẽ. Thay đổi mô hình mà không báo cáo là thiếu minh bạch.
Checklist nhanh: đã tích Collinearity diagnostics; đã báo cáo VIF và Tolerance của mọi biến; đã nêu ngưỡng kèm nguồn; đã xem Condition Index và Variance Proportions; đã centering nếu có tương tác; mọi điều chỉnh có lý do lý thuyết và được ghi lại.
Câu hỏi thường gặp về đa cộng tuyến
VIF bằng 6 có phải là đa cộng tuyến không?
Tùy ngưỡng bạn chọn. Theo ngưỡng 10 thì chưa, theo ngưỡng 5 thì có dấu hiệu. Hãy xem thêm sai số chuẩn, dấu của hệ số và cỡ mẫu như O'Brien (2007) gợi ý, thay vì chỉ nhìn một con số.
Đa cộng tuyến có làm mô hình sai không?
Không làm ước lượng chệch và không giảm khả năng dự báo, nhưng làm hệ số kém chính xác, khó diễn giải tác động riêng của từng biến.
Biến giả có cần kiểm tra VIF không?
Có. Các biến giả của cùng một biến định danh có thể có VIF cao nếu nhóm tham chiếu quá ít quan sát. Chọn nhóm tham chiếu đủ lớn sẽ cải thiện.
Có nên dùng EFA để tránh đa cộng tuyến?
EFA giúp phát hiện các biến quan sát cùng tải lên một nhân tố, từ đó tránh tách một khái niệm thành hai biến. Tuy nhiên điểm nhân tố vẫn có thể tương quan nên vẫn cần kiểm tra VIF trong hồi quy.
Hồi quy logistic kiểm tra đa cộng tuyến thế nào?
SPSS không in VIF trong Binary Logistic. Cách thường dùng là chạy hồi quy tuyến tính với cùng biến độc lập chỉ để lấy VIF, vì VIF chỉ phụ thuộc vào các biến độc lập.
Mô hình hồi quy có VIF cao?
Kaas.vn hướng dẫn chẩn đoán và xử lý đa cộng tuyến có cơ sở lý thuyết qua dịch vụ hỗ trợ SPSS, kèm bộ dữ liệu thực hành để bạn luyện. Chúng tôi giải thích và bàn giao file để bạn tự chạy lại; không viết thay, không chỉnh số liệu.
Tài liệu tham khảo
- Field, A. (2024). Discovering statistics using IBM SPSS Statistics (6th ed.). Sage.
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2-24. doi:10.1108/EBR-11-2018-0203
- Kock, N. (2015). Common method bias in PLS-SEM: A full collinearity assessment approach. International Journal of e-Collaboration, 11(4), 1-10. doi:10.4018/ijec.2015100101
- O'Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673-690. doi:10.1007/s11135-006-9018-6
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage.
Gửi mô hình (ảnh, Word, PDF) và chọn SPSS, AMOS, SmartPLS, Stata, Eviews hoặc R. Kaas.vn đề xuất phương án và báo giá miễn phí.
- SPSS AMOS là gì? Hướng dẫn 7 bước chạy CFA và SEM trên IBM SPSS AMOS
- Phương sai thay đổi: 5 bước phát hiện và xử lý trên Stata
- Hồi quy tuyến tính bội trong SPSS: 6 bước chạy và đọc kết quả chính xác
- Thuật ngữ thống kê: 20 khái niệm cần biết khi làm nghiên cứu
- Phân tích dữ liệu bảng bằng Stata: 7 bước từ FEM, REM đến GMM
Bài viết cùng chủ đề:
-

Kiểm định phi tham số: 5 phép kiểm định trên SPSS kèm effect size
-
PROCESS Macro của Hayes: 4 mô hình trung gian, điều tiết trên SPSS
-
Nhập liệu SPSS: 6 bước mã hóa biến và làm sạch dữ liệu khảo sát
-
Chi-square SPSS: 5 bước kiểm định mối liên hệ và đọc Cramer's V
-
Biến điều tiết: 5 bước kiểm định tương tác và simple slope trong SPSS
-
Phân tích biến trung gian: 5 bước bootstrap với PROCESS, AMOS, SmartPLS
-
Tương quan Pearson SPSS: 5 bước chạy và cách đọc hệ số r chính xác
-
Hồi quy logistic SPSS: 7 bước chạy Binary Logistic và cách đọc Exp(B)
-
ANOVA SPSS: 7 bước chạy One-way ANOVA, Welch, Post Hoc và cách đọc kết quả
-
T-test SPSS: 3 loại kiểm định, 6 bước chạy và cách đọc kết quả
-

Chạy định lượng là gì? Hướng dẫn 8 bước chạy định lượng cho luận văn
-

Hồi quy tuyến tính bội trong SPSS: 6 bước chạy và đọc kết quả chính xác
-

Phân tích nhân tố khám phá EFA trong SPSS: 7 bước chạy và đọc kết quả chuẩn
-

Hỗ trợ xử lý SPSS: 12 kỹ thuật phân tích và quy trình làm việc minh bạch
-

Xử lý định lượng SPSS cho luận văn: 10 lưu ý quan trọng
-

Phân tích độ tin cậy Cronbach's Alpha trong SPSS