Hồi quy logistic SPSS là phương pháp phân tích khi biến phụ thuộc chỉ có hai giá trị, như có hoặc không vay vốn, mua hoặc không mua, nghỉ việc hoặc ở lại. Bài viết hướng dẫn 7 bước chạy hồi quy logistic SPSS (Binary Logistic Regression), cách đọc Omnibus Test, Nagelkerke R², Hosmer-Lemeshow, bảng phân loại, hệ số B, Wald và tỷ số odds Exp(B), cùng ví dụ trình bày kết quả theo chuẩn APA.
Hồi quy logistic SPSS là gì?
Hồi quy tuyến tính dự báo một biến định lượng liên tục, nhưng khi biến phụ thuộc là nhị phân (0/1), giá trị dự báo có thể vượt ra ngoài khoảng 0-1 và các giả định của OLS bị vi phạm. Hồi quy logistic giải quyết vấn đề này bằng cách mô hình hóa logarit của odds (log-odds) xảy ra sự kiện:
ln(p / (1 - p)) = B0 + B1X1 + B2X2 + ... + BkXk
Trong đó p là xác suất xảy ra sự kiện (Y = 1). Hệ số được ước lượng bằng phương pháp hợp lý cực đại (maximum likelihood) thay vì bình phương nhỏ nhất. Kết quả quan trọng nhất cho diễn giải là Exp(B), tức tỷ số odds (odds ratio, OR).
Khi nào dùng hồi quy logistic SPSS?
- Kinh tế, tài chính: quyết định vay vốn của nông hộ, khả năng vỡ nợ của khách hàng.
- Marketing: ý định mua (có/không), quyết định chuyển đổi nhà cung cấp.
- Quản trị nhân sự: nhân viên nghỉ việc hay ở lại.
- Y tế công cộng: các yếu tố liên quan đến việc mắc bệnh, tuân thủ điều trị.
- Giáo dục: sinh viên tốt nghiệp đúng hạn hay không.
Khi biến phụ thuộc có nhiều hơn hai giá trị không thứ tự, dùng hồi quy logistic đa thức (Multinomial); khi có thứ tự (thấp - trung bình - cao), dùng hồi quy thứ bậc (Ordinal). Với biến phụ thuộc định lượng, dùng hồi quy tuyến tính bội.
Giả định và yêu cầu dữ liệu của hồi quy logistic SPSS
- Biến phụ thuộc nhị phân: mã hóa 0 = không xảy ra, 1 = xảy ra sự kiện quan tâm.
- Quan sát độc lập: mỗi quan sát là một đối tượng khác nhau.
- Không đa cộng tuyến nghiêm trọng: kiểm tra VIF bằng cách chạy hồi quy tuyến tính với cùng biến độc lập (VIF < 5 hoặc < 10).
- Quan hệ tuyến tính giữa biến định lượng và log-odds: có thể kiểm tra bằng Box-Tidwell.
- Đủ số sự kiện: quy tắc phổ biến là khoảng 10 sự kiện (nhóm ít hơn trong biến phụ thuộc) cho mỗi biến độc lập (Peduzzi và cộng sự, 1996). Ví dụ 6 biến độc lập cần ít nhất khoảng 60 trường hợp ở nhóm ít hơn. Xem thêm cách tính cỡ mẫu.
Hồi quy logistic không yêu cầu phân phối chuẩn của biến độc lập hay phương sai không đổi như OLS.
7 bước chạy hồi quy logistic SPSS
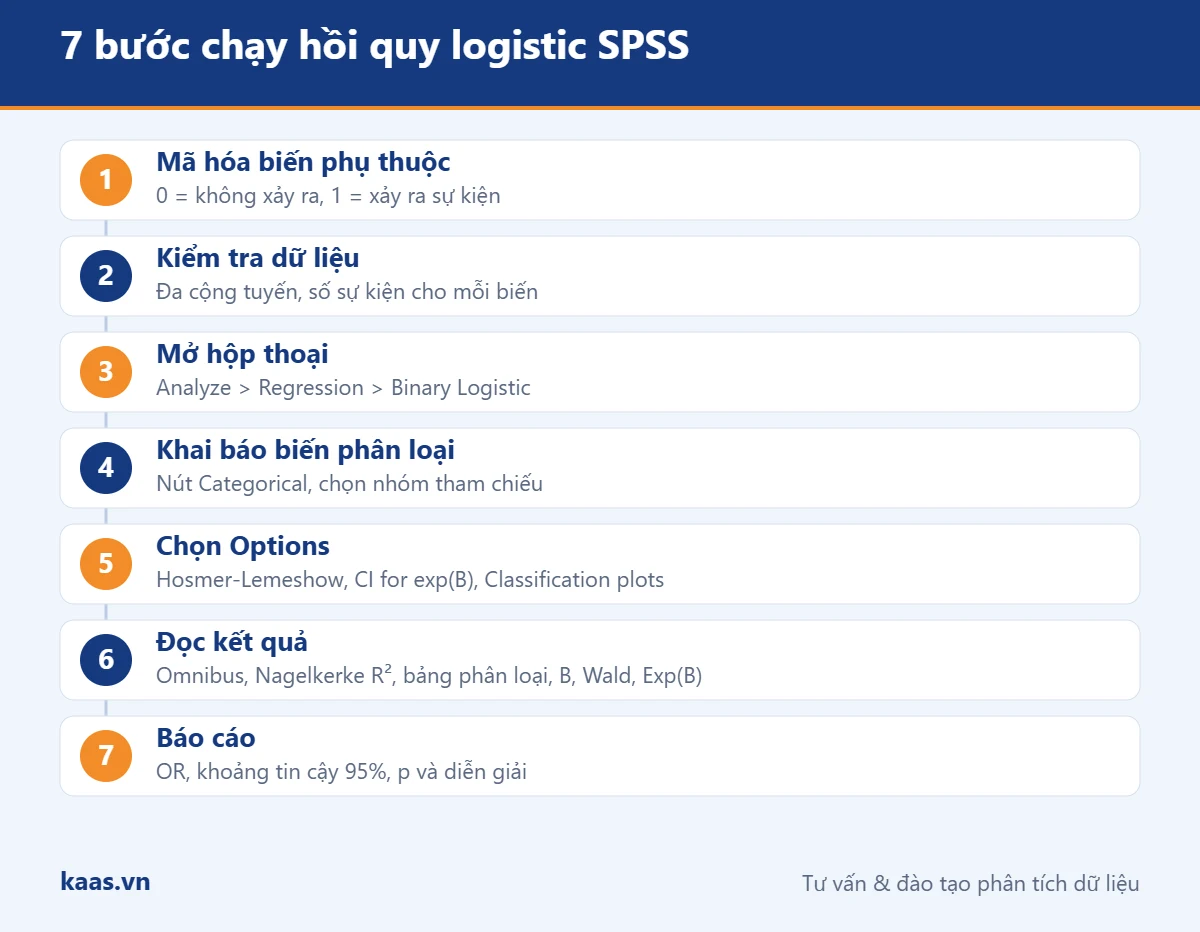
Bước 1. Mã hóa biến phụ thuộc
Đảm bảo biến phụ thuộc chỉ có hai giá trị 0 và 1, với 1 là sự kiện bạn quan tâm (ví dụ VAY = 1 nếu có vay vốn). SPSS mô hình hóa xác suất của giá trị được mã hóa cao hơn.
Bước 2. Kiểm tra dữ liệu
Chạy Frequencies cho biến phụ thuộc để biết số sự kiện, kiểm tra giá trị thiếu, giá trị ngoại lai và VIF của các biến độc lập.
Bước 3. Mở hộp thoại
Vào Analyze > Regression > Binary Logistic. Đưa biến phụ thuộc vào Dependent, các biến độc lập vào Covariates. Method: Enter (đưa tất cả biến theo lý thuyết).
Bước 4. Khai báo biến phân loại
Nhấn Categorical, đưa các biến định danh (giới tính, khu vực, nghề nghiệp) sang Categorical Covariates. Chọn Reference Category là First hoặc Last và nhấn Change; nhóm tham chiếu là nhóm dùng để so sánh với các nhóm còn lại.
Bước 5. Chọn Options
Nhấn Options, chọn Classification plots, Hosmer-Lemeshow goodness-of-fit, CI for exp(B) 95% và Casewise listing of residuals (outside 2 std. dev.) để phát hiện ngoại lai.
Bước 6. Đọc kết quả
Nhấn OK và đọc các bảng ở Block 1: Omnibus Tests, Model Summary, Hosmer and Lemeshow Test, Classification Table và Variables in the Equation.
Bước 7. Báo cáo
Báo cáo B, sai số chuẩn, Wald, p, Exp(B) và khoảng tin cậy 95% của Exp(B), kèm các chỉ số phù hợp mô hình.
Cách đọc kết quả hồi quy logistic SPSS
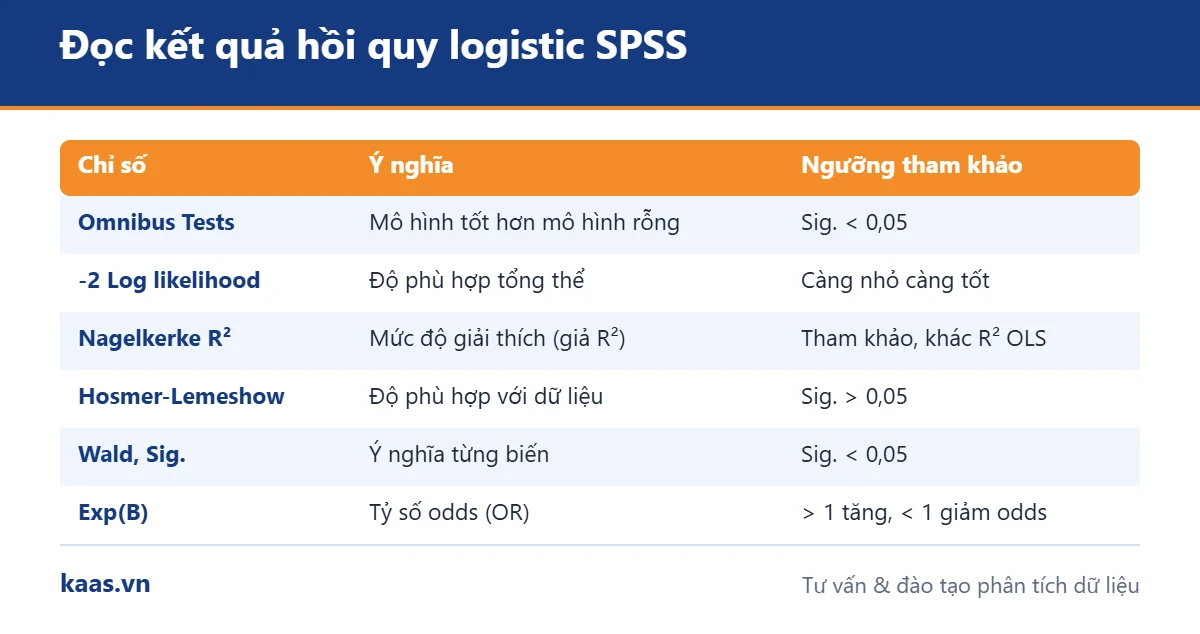
Omnibus Tests of Model Coefficients
Kiểm định mô hình có biến độc lập có tốt hơn mô hình rỗng (chỉ có hằng số) không. Sig. của dòng Model < 0,05: mô hình có ý nghĩa thống kê.
Model Summary
-2 Log likelihood càng nhỏ, mô hình càng phù hợp. Cox & Snell R² và Nagelkerke R² là các "giả R²", cho biết mức độ giải thích tương đối của mô hình. Nagelkerke R² nằm trong khoảng 0-1 nên dễ diễn giải hơn, nhưng không nên so sánh trực tiếp với R² của hồi quy tuyến tính.
Hosmer and Lemeshow Test
Kiểm định mức độ phù hợp giữa xác suất dự báo và dữ liệu thực tế. Sig. > 0,05: không có bằng chứng mô hình kém phù hợp. Lưu ý kiểm định này nhạy cảm với cỡ mẫu rất lớn.
Classification Table
Cho tỷ lệ dự báo đúng tổng thể và theo từng nhóm, với ngưỡng phân loại mặc định 0,5. So sánh với tỷ lệ dự báo đúng ở Block 0 (mô hình rỗng) để thấy mô hình cải thiện bao nhiêu. Khi hai nhóm chênh lệch nhiều, nên xem thêm đường cong ROC và diện tích AUC (Analyze > Classify > ROC Curve).
Variables in the Equation
- B: hệ số log-odds; dấu dương nghĩa là biến làm tăng khả năng xảy ra sự kiện.
- Wald và Sig.: kiểm định ý nghĩa của từng hệ số; Sig. < 0,05 là có ý nghĩa ở mức 5%.
- Exp(B): tỷ số odds. Exp(B) = 1,45 nghĩa là khi biến độc lập tăng 1 đơn vị, odds xảy ra sự kiện tăng 45% (các yếu tố khác không đổi). Exp(B) = 0,70 nghĩa là odds giảm 30%.
- 95% C.I. for EXP(B): khoảng tin cậy không chứa 1 tương ứng với hệ số có ý nghĩa.
Ví dụ hồi quy logistic SPSS: quyết định vay vốn của nông hộ
Nghiên cứu khảo sát 360 nông hộ, trong đó 142 hộ có vay vốn ngân hàng (VAY = 1). Biến độc lập: diện tích đất (ha), số năm đi học của chủ hộ, giới tính chủ hộ (1 = nam), tham gia tổ chức đoàn thể (1 = có), khoảng cách đến ngân hàng (km). Kết quả (số liệu minh họa):
| Biến | B | Wald | Sig. | Exp(B) | 95% CI Exp(B) |
|---|---|---|---|---|---|
| Diện tích đất | 0,42 | 9,86 | 0,002 | 1,52 | [1,17; 1,98] |
| Số năm đi học | 0,11 | 7,21 | 0,007 | 1,12 | [1,03; 1,21] |
| Giới tính (nam) | 0,18 | 0,52 | 0,471 | 1,20 | [0,73; 1,96] |
| Tham gia đoàn thể | 0,76 | 10,43 | 0,001 | 2,14 | [1,35; 3,40] |
| Khoảng cách đến ngân hàng | -0,09 | 6,05 | 0,014 | 0,91 | [0,85; 0,98] |
Omnibus: χ²(5) = 48,3; p < 0,001. Nagelkerke R² = 0,17. Hosmer-Lemeshow: χ²(8) = 6,92; p = 0,545. Tỷ lệ dự báo đúng 68,1% (mô hình rỗng 60,6%).
Diễn giải: các yếu tố có ý nghĩa thống kê gồm diện tích đất, số năm đi học, tham gia đoàn thể và khoảng cách đến ngân hàng. Odds vay vốn của hộ tham gia tổ chức đoàn thể cao gấp 2,14 lần hộ không tham gia; mỗi km cách xa ngân hàng làm odds vay vốn giảm khoảng 9%. Giới tính chủ hộ chưa cho thấy ảnh hưởng có ý nghĩa.
Viết theo APA: "Mô hình hồi quy logistic có ý nghĩa thống kê, χ²(5) = 48,3; p < 0,001, giải thích khoảng 17% biến thiên (Nagelkerke R²) và phân loại đúng 68,1% trường hợp. Tham gia tổ chức đoàn thể làm tăng odds vay vốn (OR = 2,14; KTC 95% [1,35; 3,40]; p = 0,001)."
Odds ratio trong hồi quy logistic SPSS: tránh diễn giải sai
Exp(B) = 2,14 không có nghĩa là "xác suất vay vốn cao gấp 2,14 lần". Odds và xác suất là hai đại lượng khác nhau: odds = p / (1 - p). Khi xác suất nền là 40% (odds 0,67), odds tăng gấp 2,14 lần thành 1,43, tương ứng xác suất khoảng 59%. Nếu muốn trình bày theo xác suất, hãy tính xác suất dự báo cho các kịch bản cụ thể hoặc dùng tác động biên (marginal effects) bằng phần mềm như Stata hoặc R. Xem thêm hỗ trợ chạy Stata.
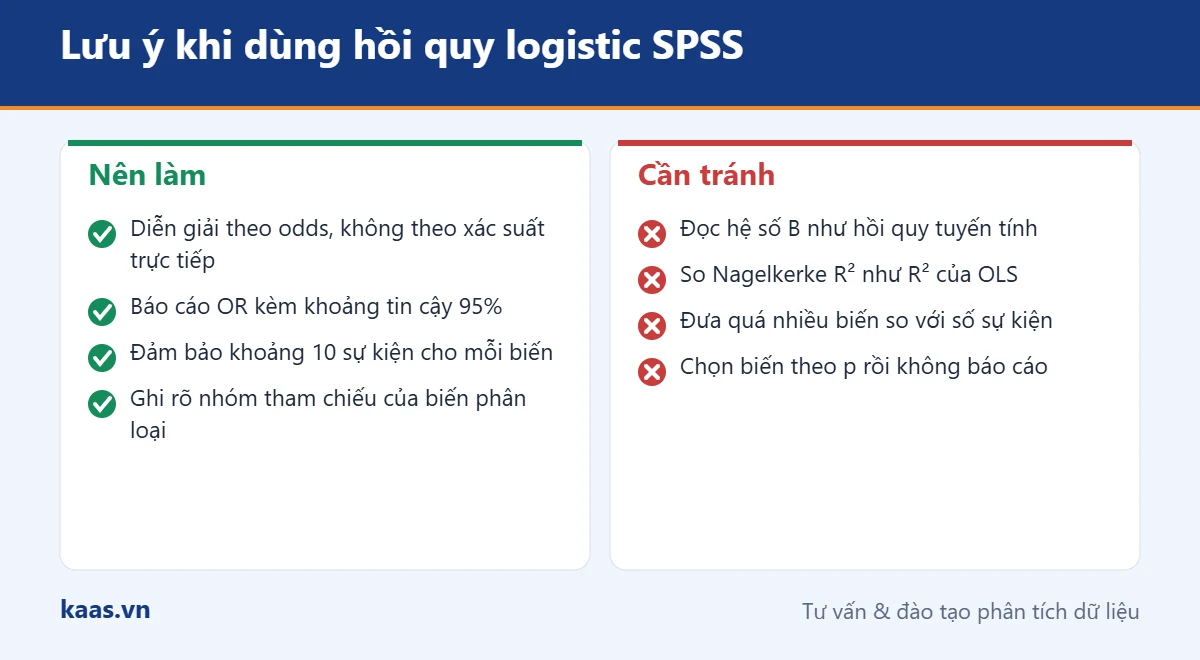
Lỗi thường gặp khi chạy hồi quy logistic SPSS
- Đọc hệ số B như hồi quy tuyến tính: B là thay đổi log-odds, không phải thay đổi xác suất.
- So Nagelkerke R² với R² của OLS: giả R² thường thấp hơn và không có cùng ý nghĩa.
- Quá nhiều biến so với số sự kiện: dẫn đến ước lượng không ổn định, sai số chuẩn rất lớn.
- Quên khai báo Categorical: biến định danh nhiều nhóm bị xử lý như biến định lượng.
- Dùng Stepwise rồi không báo cáo: chọn biến hoàn toàn theo p làm kết quả thiếu cơ sở lý thuyết; nếu dùng, phải nêu rõ.
- Bỏ qua tách biệt hoàn toàn (complete separation): khi một biến dự báo hoàn hảo kết quả, SPSS cho hệ số và sai số cực lớn; cần xem lại biến hoặc gộp nhóm.
Chạy hồi quy logistic SPSS bằng cú pháp
LOGISTIC REGRESSION VARIABLES VAY
  /METHOD=ENTER DIENTICH HOCVAN GIOITINH DOANTHE KHOANGCACH
  /CONTRAST (GIOITINH)=Indicator(1)
  /CONTRAST (DOANTHE)=Indicator(1)
  /PRINT=GOODFIT CI(95)
  /CRITERIA=PIN(0.05) POUT(0.10) ITERATE(20) CUT(0.5).
Lưu cú pháp giúp bạn chạy lại toàn bộ mô hình khi cập nhật dữ liệu, và giúp giảng viên hướng dẫn kiểm tra lại quy trình phân tích một cách minh bạch.
Trình bày hồi quy logistic SPSS trong luận văn
- Mô tả biến phụ thuộc: số và tỷ lệ trường hợp ở mỗi nhóm.
- Bảng thống kê mô tả các biến độc lập theo từng nhóm của biến phụ thuộc.
- Bảng kết quả: B, S.E., Wald, p, Exp(B), khoảng tin cậy 95% cho từng biến.
- Các chỉ số phù hợp: Omnibus, -2LL, Nagelkerke R², Hosmer-Lemeshow, tỷ lệ phân loại đúng (và AUC nếu có).
- Diễn giải theo odds ratio, sau đó thảo luận ý nghĩa thực tiễn và so sánh với nghiên cứu trước.
Đánh giá khả năng dự báo của hồi quy logistic SPSS bằng ROC
Tỷ lệ phân loại đúng phụ thuộc vào ngưỡng 0,5, nên có thể gây hiểu lầm khi hai nhóm chênh lệch nhiều. Đường cong ROC đánh giá khả năng phân biệt của mô hình ở mọi ngưỡng:
- Trong hộp thoại hồi quy logistic SPSS, nhấn Save và chọn Predicted Values: Probabilities để lưu xác suất dự báo (biến PRE_1).
- Vào Analyze > Classify > ROC Curve, đưa PRE_1 vào Test Variable, biến phụ thuộc vào State Variable, Value of State Variable = 1.
- Chọn ROC Curve, With diagonal reference line, Standard error and confidence interval.
- Đọc diện tích dưới đường cong (AUC): 0,7-0,8 là chấp nhận được, 0,8-0,9 là tốt, trên 0,9 là rất tốt (Hosmer và cộng sự, 2013).
Mở rộng hồi quy logistic SPSS: đa thức và thứ bậc
| Biến phụ thuộc | Mô hình | Menu SPSS | Ví dụ |
|---|---|---|---|
| 2 giá trị | Binary logistic | Regression > Binary Logistic | Vay hoặc không vay |
| Từ 3 giá trị, không thứ tự | Multinomial logistic | Regression > Multinomial Logistic | Chọn ngân hàng A, B hoặc C |
| Từ 3 giá trị, có thứ tự | Ordinal logistic | Regression > Ordinal | Mức hài lòng thấp, trung bình, cao |
Với mô hình đa thức, mỗi nhóm được so sánh với một nhóm tham chiếu, nên số hệ số tăng nhanh và cần cỡ mẫu lớn hơn. Với mô hình thứ bậc, cần kiểm tra giả định tỷ lệ odds song song (Test of Parallel Lines). Nguyên tắc đọc Exp(B) tương tự như hồi quy logistic SPSS nhị phân.
Biến tương tác trong hồi quy logistic SPSS
Khi muốn kiểm tra tác động của một biến có thay đổi theo nhóm hay không (ví dụ tác động của học vấn đến quyết định vay có khác nhau giữa nam và nữ), thêm biến tương tác vào mô hình: trong hộp thoại Binary Logistic, chọn đồng thời hai biến ở danh sách bên trái rồi nhấn nút >a*b>.
Nếu hệ số tương tác có ý nghĩa, không nên diễn giải tác động chính của từng biến một cách riêng lẻ; hãy tính odds ratio theo từng nhóm hoặc vẽ đồ thị xác suất dự báo. Diễn giải tương tác trong mô hình phi tuyến như logistic khá phức tạp, nên trình bày kèm ví dụ số cụ thể để người đọc dễ hiểu.
Checklist hoàn thành hồi quy logistic SPSS
- Biến phụ thuộc mã hóa 0/1, với 1 là sự kiện quan tâm.
- Đủ khoảng 10 sự kiện cho mỗi biến độc lập.
- Đã kiểm tra đa cộng tuyến và khai báo đúng biến phân loại, nhóm tham chiếu.
- Đã báo cáo Omnibus, -2LL, Nagelkerke R², Hosmer-Lemeshow, tỷ lệ phân loại đúng và AUC.
- Bảng hệ số có B, S.E., Wald, p, Exp(B) và khoảng tin cậy 95%.
- Diễn giải theo odds ratio, không nhầm với xác suất.
- Đã lưu cú pháp hồi quy logistic SPSS để tái lập kết quả.
Câu hỏi thường gặp về hồi quy logistic SPSS
Nagelkerke R² thấp có sao không?
Giả R² trong hồi quy logistic thường thấp hơn R² của OLS. Hãy đánh giá mô hình dựa trên nhiều chỉ số cùng lúc và mục tiêu nghiên cứu (giải thích hay dự báo).
Biến độc lập là thang Likert có dùng được không?
Được. Thường dùng điểm trung bình của nhân tố sau khi đã kiểm định Cronbach's Alpha và EFA; Exp(B) khi đó là thay đổi odds khi điểm nhân tố tăng 1 đơn vị.
Khi nào nên dùng Probit thay vì Logit?
Hai mô hình thường cho kết luận tương tự. Logit phổ biến hơn trong khoa học xã hội vì diễn giải qua odds ratio thuận tiện; Probit hay gặp trong kinh tế lượng.
Hồi quy logistic SPSS có cần biến kiểm soát không?
Nên đưa vào các biến kiểm soát quan trọng theo lý thuyết và nghiên cứu trước để tránh thiên lệch do bỏ sót biến.
Cần hướng dẫn hồi quy logistic SPSS trên dữ liệu của bạn?
Kaas.vn hướng dẫn mã hóa biến, chạy mô hình và giải thích odds ratio; bạn nhận file syntax để tự chạy lại. Xem hỗ trợ xử lý SPSS hoặc gọi 0947 971 630 (Zalo).
Tài liệu tham khảo
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied Logistic Regression (3rd ed.). Wiley.
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373-1379. doi:10.1016/S0895-4356(96)00236-3
- Field, A. (2018). Discovering Statistics Using IBM SPSS Statistics (5th ed.). SAGE.
- Hỗ trợ chạy Stata: 6 bước phân tích dữ liệu bảng, hồi quy và kiểm định
- Phân tích độ tin cậy Cronbach's Alpha trong SPSS
- Hồi quy tuyến tính bội trong SPSS: 6 bước chạy và đọc kết quả chính xác
- Trắc lượng thư mục với VOSviewer: 7 bước từ tìm kiếm đến bản đồ tri thức
- Thang đo thống kê: Bí kíp phân loại trong 3 giây
Bài viết cùng chủ đề:
-

ANOVA SPSS: 7 bước chạy One-way ANOVA, Welch, Post Hoc và cách đọc kết quả
-
T-test SPSS: 3 loại kiểm định, 6 bước chạy và cách đọc kết quả
-

Chạy định lượng là gì? Hướng dẫn 8 bước chạy định lượng cho luận văn
-

Hồi quy tuyến tính bội trong SPSS: 6 bước chạy và đọc kết quả chính xác
-

Phân tích nhân tố khám phá EFA trong SPSS: 7 bước chạy và đọc kết quả chuẩn
-

Hỗ trợ xử lý SPSS: 12 kỹ thuật phân tích và quy trình làm việc minh bạch
-

Xử lý định lượng SPSS cho luận văn: 10 lưu ý quan trọng
-

Phân tích độ tin cậy Cronbach's Alpha trong SPSS
-

Thang đo thống kê: Bí kíp phân loại trong 3 giây
-

Thuật ngữ thống kê: 20 khái niệm cần biết khi làm nghiên cứu
-
Thống kê mô tả SPSS: 7 bước chạy và đọc kết quả trung bình, độ lệch chuẩn