Chi-square SPSS (kiểm định Chi bình phương, χ²) là công cụ dùng để kiểm tra mối liên hệ giữa hai biến phân loại: giới tính và lựa chọn ngân hàng, nhóm tuổi và kênh mua sắm, ngành học và dự định làm việc sau tốt nghiệp. Đây là phân tích xuất hiện trong rất nhiều luận văn ở phần thống kê mô tả và so sánh nhóm. Bài viết hướng dẫn chi tiết 5 bước chạy Chi-square SPSS qua Crosstabs, cách đọc bảng chéo, giá trị kỳ vọng, Pearson Chi-Square, Cramer's V, khi nào dùng Fisher's exact test và cách báo cáo theo chuẩn APA.
Chi-square SPSS là gì?
Kiểm định Chi-square độc lập (Chi-square test of independence) so sánh tần số quan sát được trong bảng chéo với tần số kỳ vọng nếu hai biến hoàn toàn không liên quan với nhau. Khi chênh lệch giữa hai tần số này đủ lớn, giá trị χ² lớn và p nhỏ, ta có bằng chứng bác bỏ giả thuyết H0 "hai biến độc lập".
Công thức cơ bản:
χ² = Σ (O - E)² / E
Trong đó O là tần số quan sát, E là tần số kỳ vọng của từng ô. Tần số kỳ vọng E của một ô bằng (tổng hàng × tổng cột) / tổng mẫu.
Trong phần mềm, Chi-square SPSS được thực hiện qua menu Analyze > Descriptive Statistics > Crosstabs. Ngoài kiểm định độc lập, SPSS còn có kiểm định Chi-square phù hợp (goodness of fit) cho một biến trong menu Nonparametric Tests, được đề cập ở cuối bài.
Khi nào dùng Chi-square SPSS?
Bạn dùng Chi-square SPSS khi cả hai biến đều là biến phân loại (danh nghĩa hoặc thứ bậc với ít nhóm). Một số câu hỏi nghiên cứu điển hình:
- Tỷ lệ sử dụng ví điện tử có khác nhau giữa các nhóm tuổi không?
- Giới tính có liên quan đến việc lựa chọn ngành học không?
- Khu vực sinh sống (thành thị, nông thôn) có liên quan đến việc tham gia bảo hiểm y tế tự nguyện không?
- Loại hình doanh nghiệp có liên quan đến việc áp dụng chuyển đổi số không?
Nếu biến phụ thuộc là biến định lượng (điểm hài lòng, thu nhập), bạn cần dùng T-test hoặc ANOVA thay vì Chi-square SPSS. Nếu muốn dự báo xác suất một biến nhị phân từ nhiều biến, dùng hồi quy logistic.
Giả định của Chi-square SPSS
- Hai biến phân loại: mỗi quan sát thuộc đúng một nhóm của mỗi biến.
- Quan sát độc lập: mỗi người chỉ xuất hiện một lần trong bảng. Với thiết kế đo lặp trên cùng đối tượng (trước - sau), dùng kiểm định McNemar.
- Tần số kỳ vọng đủ lớn: không quá 20% số ô có tần số kỳ vọng nhỏ hơn 5, và không ô nào có tần số kỳ vọng nhỏ hơn 1 (Cochran, 1954). SPSS tự báo cáo tỷ lệ này dưới bảng kết quả.
- Dữ liệu là tần số đếm, không phải tỷ lệ phần trăm hay giá trị trung bình.
Khi giả định về tần số kỳ vọng bị vi phạm, có thể gộp nhóm (nếu có ý nghĩa nội dung), dùng Fisher's exact test, hoặc dùng phương pháp Exact trong SPSS (nếu có module Exact Tests).
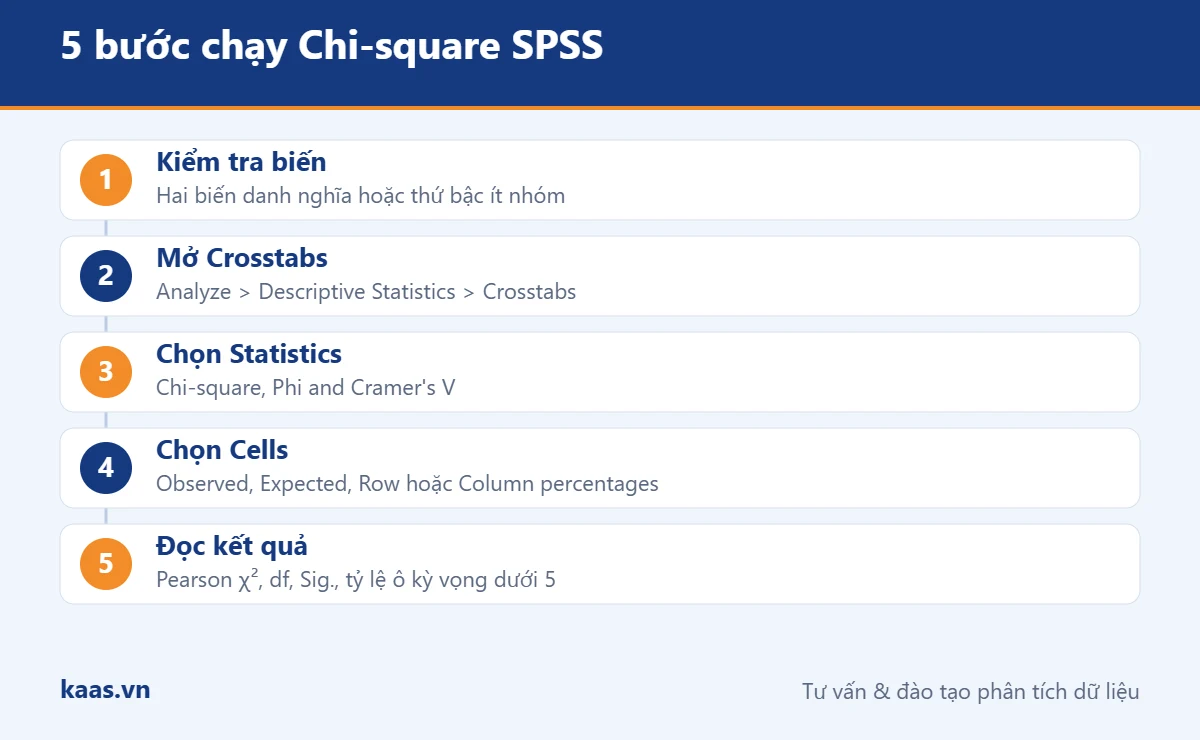
5 bước chạy Chi-square SPSS
Bước 1: Kiểm tra và mã hóa biến
Đảm bảo hai biến đã được mã hóa số và gán nhãn giá trị trong Variable View, ví dụ Giới tính: 1 = Nam, 2 = Nữ; Kênh mua sắm: 1 = Cửa hàng, 2 = Sàn thương mại điện tử, 3 = Mạng xã hội, 4 = Website thương hiệu. Chạy Frequencies để kiểm tra không có giá trị ngoài mã. Xem thêm nhập liệu SPSS.
Bước 2: Mở hộp thoại Crosstabs
Vào Analyze > Descriptive Statistics > Crosstabs. Đưa biến độc lập (ví dụ nhóm tuổi) vào ô Row(s) và biến phụ thuộc (kênh mua sắm) vào ô Column(s). Nếu muốn phân tích theo từng lớp của biến thứ ba (ví dụ theo khu vực), đưa biến đó vào ô Layer.
Bước 3: Chọn Statistics
Nhấn nút Statistics, tick Chi-square. Trong mục Nominal, tick Phi and Cramer's V để đo độ mạnh của mối liên hệ. Với biến thứ bậc, có thể tick thêm Gamma hoặc Kendall's tau-b.
Bước 4: Chọn Cells
Nhấn nút Cells, tick Observed và Expected trong mục Counts. Trong mục Percentages, tick Row nếu biến độc lập nằm ở hàng, để so sánh tỷ lệ giữa các nhóm. Có thể tick Adjusted standardized trong mục Residuals để biết ô nào đóng góp nhiều vào kết quả.
Cú pháp tương đương:
CROSSTABS
  /TABLES=NHOMTUOI BY KENHMUA
  /STATISTICS=CHISQ PHI
  /CELLS=COUNT EXPECTED ROW ASRESID
  /COUNT ROUND CELL.
Bước 5: Đọc kết quả
SPSS trả về ba bảng chính: Case Processing Summary, bảng chéo Crosstabulation và bảng Chi-Square Tests, kèm bảng Symmetric Measures nếu bạn chọn Cramer's V.
Cách đọc kết quả Chi-square SPSS
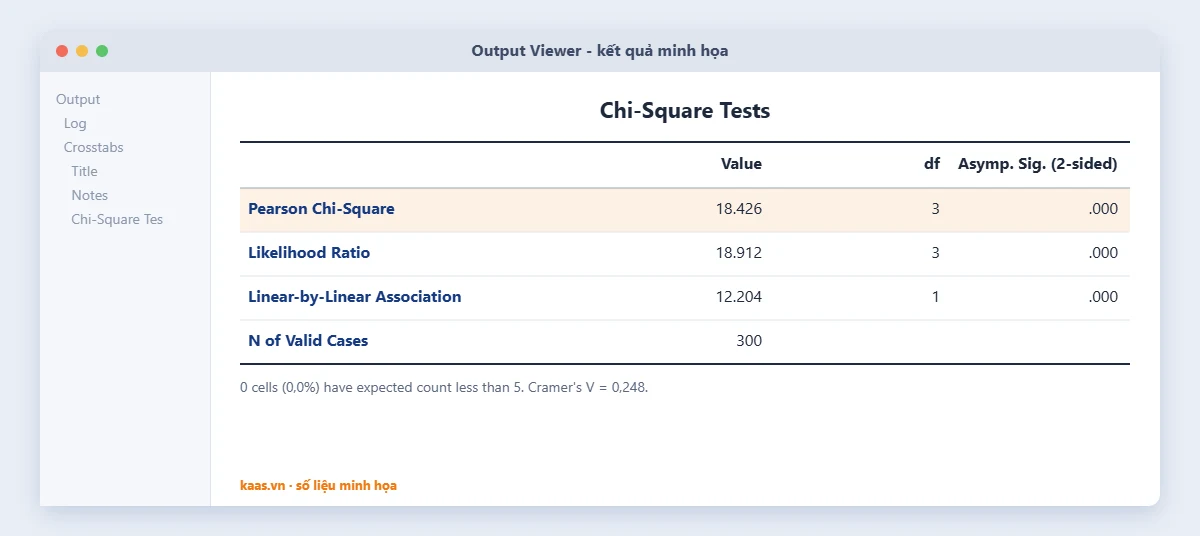
Bảng minh họa trên là kết quả Chi-square SPSS cho mối liên hệ giữa nhóm tuổi (4 nhóm) và việc có mua sắm qua mạng xã hội hay không (2 nhóm), cỡ mẫu 300. Số liệu chỉ mang tính minh họa.
Bảng Chi-Square Tests
- Pearson Chi-Square: χ² = 18,426, df = 3, p < 0,001. Đây là dòng kết quả chính cần báo cáo. Bậc tự do df = (số hàng - 1) × (số cột - 1) = (4 - 1) × (2 - 1) = 3.
- Likelihood Ratio: một cách tính khác, cho kết quả gần tương tự với mẫu lớn.
- Linear-by-Linear Association: chỉ có ý nghĩa khi cả hai biến là thứ bậc, kiểm định xu hướng tuyến tính.
- Dòng chú thích: "0 cells (0,0%) have expected count less than 5" cho thấy giả định về tần số kỳ vọng được thỏa mãn.
Bảng Crosstabulation
Kết quả có ý nghĩa chỉ cho biết hai biến có liên hệ; để biết liên hệ như thế nào, bạn cần đọc tỷ lệ phần trăm theo hàng. Ví dụ minh họa:
| Nhóm tuổi | Có mua qua mạng xã hội | Không mua | Tổng |
|---|---|---|---|
| 18 - 24 | 52 (65,0%) | 28 (35,0%) | 80 |
| 25 - 34 | 48 (53,3%) | 42 (46,7%) | 90 |
| 35 - 44 | 30 (42,9%) | 40 (57,1%) | 70 |
| Từ 45 | 18 (30,0%) | 42 (70,0%) | 60 |
| Tổng | 148 (49,3%) | 152 (50,7%) | 300 |
Tỷ lệ mua qua mạng xã hội giảm dần theo nhóm tuổi, từ 65,0% ở nhóm 18 - 24 xuống 30,0% ở nhóm từ 45 tuổi.
Phần dư chuẩn hóa điều chỉnh
Ô có adjusted standardized residual lớn hơn 1,96 hoặc nhỏ hơn -1,96 là ô có tần số quan sát khác biệt đáng kể so với kỳ vọng. Trong ví dụ, nhóm 18 - 24 có phần dư dương lớn ở cột "Có mua" và nhóm từ 45 có phần dư âm lớn, đây là hai nhóm đóng góp chính vào kết quả Chi-square SPSS.
Đo độ mạnh mối liên hệ bằng Cramer's V
Giá trị p của Chi-square SPSS phụ thuộc mạnh vào cỡ mẫu: với mẫu rất lớn, một khác biệt nhỏ cũng có ý nghĩa thống kê. Vì vậy cần báo cáo thêm độ mạnh của mối liên hệ.
- Phi (φ): dùng cho bảng 2×2, giá trị từ 0 đến 1.
- Cramer's V: dùng cho bảng lớn hơn 2×2, giá trị từ 0 đến 1. Công thức V = √(χ² / (N × (k - 1))), với k là số hàng hoặc số cột nhỏ hơn.
| df* = min(hàng, cột) - 1 | Nhỏ | Trung bình | Lớn |
|---|---|---|---|
| 1 | 0,10 | 0,30 | 0,50 |
| 2 | 0,07 | 0,21 | 0,35 |
| 3 | 0,06 | 0,17 | 0,29 |
Ngưỡng theo Cohen (1988). Trong ví dụ, bảng 4×2 có df* = 1 và Cramer's V = 0,248, nên mức liên hệ ở khoảng nhỏ đến trung bình.
Fisher's exact test và hiệu chỉnh Yates
Với bảng 2×2, SPSS tự động trả thêm hai dòng:
- Continuity Correction (Yates): hiệu chỉnh liên tục, cho kết quả bảo thủ hơn. Nhiều tác giả hiện nay không khuyến nghị dùng.
- Fisher's Exact Test: tính xác suất chính xác, không dựa vào xấp xỉ. Nên dùng khi có ô có tần số kỳ vọng nhỏ hơn 5 trong bảng 2×2.
Với bảng lớn hơn và mẫu nhỏ, có thể dùng nút Exact trong hộp thoại Crosstabs (nếu bản SPSS có module Exact Tests) hoặc chọn Monte Carlo.
Chi-square SPSS với biến kiểm soát: phân tích theo lớp
Mối liên hệ giữa hai biến có thể bị chi phối bởi một biến thứ ba. Ví dụ: nhóm tuổi có liên hệ với việc mua qua mạng xã hội, nhưng có thể một phần do người trẻ sống ở thành thị nhiều hơn. Để kiểm tra, bạn đưa biến khu vực vào ô Layer 1 of 1 trong Crosstabs.
SPSS sẽ trả về bảng chéo và kết quả Chi-square SPSS riêng cho từng khu vực. Nếu mối liên hệ vẫn có ý nghĩa ở cả thành thị và nông thôn, kết luận về nhóm tuổi vững hơn. Nếu mối liên hệ chỉ xuất hiện ở một khu vực, đó là dấu hiệu của tương tác cần được thảo luận.
Với bảng 2×2 theo nhiều lớp, tick thêm Cochran's and Mantel-Haenszel statistics trong Statistics. Kiểm định này cho biết mối liên hệ có đồng nhất giữa các lớp không (Breslow-Day) và ước lượng tỷ số chênh chung (common odds ratio) sau khi kiểm soát biến lớp.
Ví dụ thực hành: tham gia bảo hiểm y tế tự nguyện
Một đề tài khảo sát 420 hộ gia đình (số liệu minh họa) muốn biết trình độ học vấn của chủ hộ (3 nhóm: dưới THPT, THPT, trên THPT) có liên quan đến việc tham gia bảo hiểm y tế tự nguyện (có, không) hay không.
Kết quả cho thấy tỷ lệ tham gia lần lượt là 38,2%, 51,6% và 67,4%. Kiểm định cho χ²(2, N = 420) = 21,08, p < 0,001, Cramer's V = 0,22. Không có ô nào có tần số kỳ vọng nhỏ hơn 5.
Phần dư chuẩn hóa điều chỉnh cho thấy nhóm dưới THPT có số hộ tham gia thấp hơn kỳ vọng (-3,6), còn nhóm trên THPT cao hơn kỳ vọng (3,9). Nhóm THPT gần với mức kỳ vọng.
Diễn giải: có mối liên hệ ở mức trung bình giữa trình độ học vấn và việc tham gia bảo hiểm. Tuy nhiên, học vấn có thể đi kèm thu nhập, nên đề tài nên bổ sung hồi quy logistic có kiểm soát thu nhập trước khi đưa ra hàm ý chính sách.
So sánh Chi-square SPSS với các kiểm định liên quan
| Tình huống | Kiểm định phù hợp |
|---|---|
| Hai biến phân loại, nhóm độc lập | Chi-square độc lập |
| Bảng 2×2, ô kỳ vọng nhỏ | Fisher's exact test |
| Biến nhị phân đo hai lần trên cùng người | McNemar |
| Một biến, so với tỷ lệ cho trước | Chi-square phù hợp |
| Hai biến thứ bậc, muốn đo xu hướng | Gamma, Kendall's tau-b, Linear-by-Linear |
Những lỗi thường gặp khi chạy Chi-square SPSS
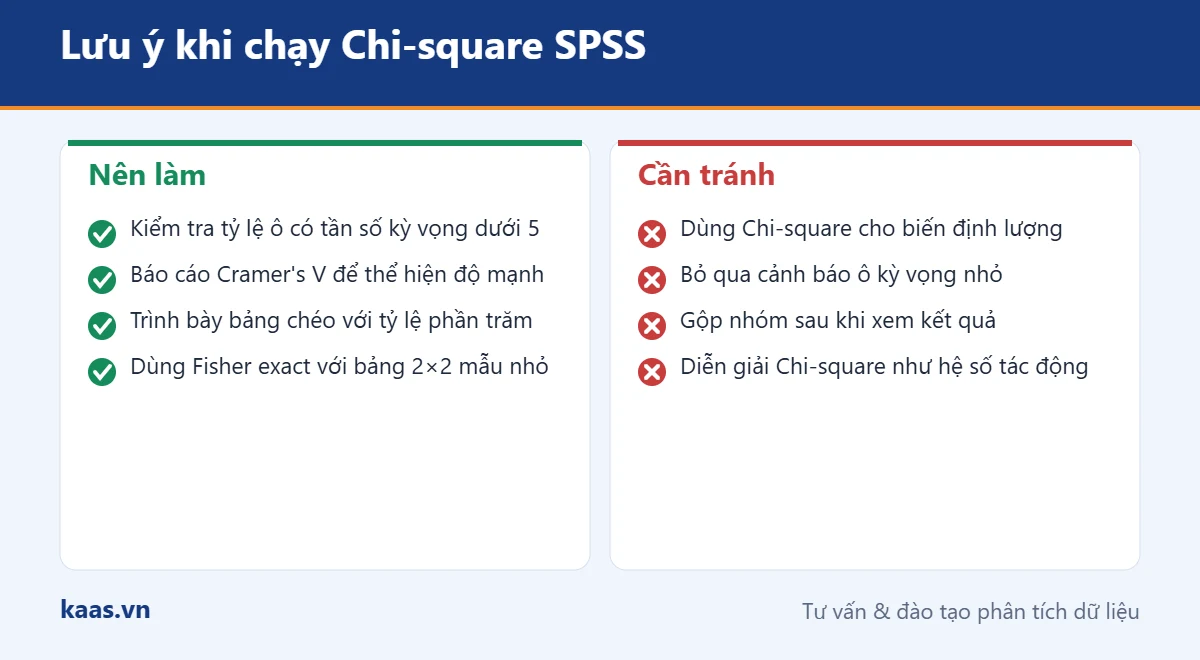
Dùng Chi-square cho biến định lượng
Chia điểm hài lòng thành nhóm "cao" và "thấp" để chạy Chi-square SPSS làm mất thông tin. Nếu biến phụ thuộc là định lượng, hãy dùng kiểm định so sánh trung bình.
Bỏ qua cảnh báo tần số kỳ vọng nhỏ
Dòng chú thích dưới bảng Chi-Square Tests cần được đọc mỗi lần. Nếu trên 20% số ô có tần số kỳ vọng nhỏ hơn 5, kết quả Pearson Chi-Square không đáng tin cậy.
Gộp nhóm sau khi xem kết quả
Gộp nhóm nhằm thỏa mãn giả định là hợp lý nếu có lý do nội dung và được quyết định trước. Gộp nhóm thử nhiều cách cho đến khi p < 0,05 là thực hành không minh bạch.
Diễn giải Chi-square như quan hệ nhân quả
"Nhóm tuổi quyết định kênh mua sắm" là diễn giải quá mức. Chi-square SPSS chỉ cho phép kết luận "có mối liên hệ có ý nghĩa thống kê giữa nhóm tuổi và kênh mua sắm".
Một người trả lời nhiều lựa chọn
Câu hỏi nhiều lựa chọn (multiple response) không thể đưa trực tiếp vào Crosstabs vì vi phạm giả định độc lập. Cần dùng Multiple Response Sets và phân tích phù hợp.
Kiểm định Chi-square phù hợp cho một biến
Khi muốn kiểm tra phân phối của một biến có khớp với tỷ lệ kỳ vọng hay không (ví dụ cơ cấu mẫu theo giới tính có khớp với tổng thể 52% nữ không), dùng Analyze > Nonparametric Tests > Legacy Dialogs > Chi-square. Trong mục Expected Values, nhập tỷ lệ kỳ vọng theo thứ tự mã nhóm. Kiểm định này thường được dùng để đánh giá tính đại diện của mẫu khảo sát.
Cách báo cáo Chi-square SPSS theo APA
Kiểm định Chi-square cho thấy có mối liên hệ có ý nghĩa thống kê giữa nhóm tuổi và việc mua sắm qua mạng xã hội, χ²(3, N = 300) = 18,43, p < 0,001, Cramer's V = 0,25.
Tỷ lệ mua qua mạng xã hội cao nhất ở nhóm 18 - 24 tuổi (65,0%) và thấp nhất ở nhóm từ 45 tuổi (30,0%).
Bảng trình bày nên có tần số và tỷ lệ phần trăm theo hàng, kèm dòng χ², df, p và Cramer's V dưới bảng. Không nên chụp nguyên bảng output SPSS đưa vào luận văn.
Checklist trước khi nộp kết quả Chi-square SPSS
- Cả hai biến là biến phân loại, mỗi người chỉ thuộc một ô.
- Đã kiểm tra tỷ lệ ô có tần số kỳ vọng nhỏ hơn 5.
- Báo cáo χ², df, N, p và Cramer's V (hoặc Phi).
- Trình bày bảng chéo với tỷ lệ phần trăm phù hợp chiều so sánh.
- Dùng Fisher's exact test khi bảng 2×2 có ô kỳ vọng nhỏ.
- Lưu cú pháp để tái lập kết quả Chi-square SPSS.
Câu hỏi thường gặp về Chi-square SPSS
Chọn dòng nào trong bảng Chi-Square Tests để báo cáo?
Thông thường là dòng Pearson Chi-Square. Với bảng 2×2 có ô kỳ vọng nhỏ, báo cáo Fisher's Exact Test.
Cỡ mẫu bao nhiêu là đủ cho Chi-square SPSS?
Không có con số cố định; điều kiện quan trọng là tần số kỳ vọng mỗi ô. Bảng càng nhiều ô thì càng cần mẫu lớn. Xem cách tính cỡ mẫu.
Biến điều tra theo thang Likert có dùng Chi-square được không?
Về kỹ thuật là được, nhưng thang 5 mức tạo nhiều ô và dễ vi phạm giả định. Với điểm trung bình nhiều câu Likert, nên dùng kiểm định so sánh trung bình.
Chi-square có ý nghĩa nhưng Cramer's V nhỏ thì kết luận thế nào?
Có mối liên hệ về mặt thống kê nhưng mức độ yếu. Bạn nên nêu cả hai thông tin và thận trọng khi đưa ra hàm ý quản trị.
Cần hướng dẫn chạy Chi-square và thống kê mô tả cho luận văn?
Kaas.vn hướng dẫn chọn kiểm định, chạy phân tích và trình bày bảng kết quả; bạn nhận file cú pháp để tự chạy lại. Xem hỗ trợ xử lý SPSS hoặc gọi 0947 971 630 (Zalo).
Tài liệu tham khảo
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417-451. doi:10.2307/3001616
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum.
- Field, A. (2018). Discovering Statistics Using IBM SPSS Statistics (5th ed.). SAGE.
- Dịch vụ phân tích dữ liệu nghiên cứu: quy trình 6 bước minh bạch, tái lập được
- Hồi quy tuyến tính bội trong SPSS: 6 bước chạy và đọc kết quả chính xác
- Thuật ngữ thống kê: 20 khái niệm cần biết khi làm nghiên cứu
- Dịch vụ khảo sát nghiên cứu: 7 bước thu thập dữ liệu thật, minh bạch
- SPSS AMOS là gì? Hướng dẫn 7 bước chạy CFA và SEM trên IBM SPSS AMOS
Bài viết cùng chủ đề:
-

Nhập liệu SPSS: 6 bước mã hóa biến và làm sạch dữ liệu khảo sát
-
Biến điều tiết: 5 bước kiểm định tương tác và simple slope trong SPSS
-
Phân tích biến trung gian: 5 bước bootstrap với PROCESS, AMOS, SmartPLS
-
Tương quan Pearson SPSS: 5 bước chạy và cách đọc hệ số r chính xác
-
Hồi quy logistic SPSS: 7 bước chạy Binary Logistic và cách đọc Exp(B)
-
ANOVA SPSS: 7 bước chạy One-way ANOVA, Welch, Post Hoc và cách đọc kết quả
-
T-test SPSS: 3 loại kiểm định, 6 bước chạy và cách đọc kết quả
-

Chạy định lượng là gì? Hướng dẫn 8 bước chạy định lượng cho luận văn
-

Hồi quy tuyến tính bội trong SPSS: 6 bước chạy và đọc kết quả chính xác
-

Phân tích nhân tố khám phá EFA trong SPSS: 7 bước chạy và đọc kết quả chuẩn
-

Hỗ trợ xử lý SPSS: 12 kỹ thuật phân tích và quy trình làm việc minh bạch
-

Xử lý định lượng SPSS cho luận văn: 10 lưu ý quan trọng
-

Phân tích độ tin cậy Cronbach's Alpha trong SPSS
-

Thang đo thống kê: Bí kíp phân loại trong 3 giây
-

Thuật ngữ thống kê: 20 khái niệm cần biết khi làm nghiên cứu
-
Thống kê mô tả SPSS: 7 bước chạy và đọc kết quả trung bình, độ lệch chuẩn