

Kiểm định Hausman là bước quyết định khi bạn làm việc với dữ liệu bảng (panel data): chọn mô hình tác động cố định (FEM) hay mô hình tác động ngẫu nhiên (REM). Đây là nội dung gần như bắt buộc trong các luận văn tài chính, ngân hàng, kinh tế phát triển sử dụng dữ liệu nhiều doanh nghiệp, nhiều tỉnh hoặc nhiều quốc gia qua nhiều năm. Bài viết hướng dẫn chi tiết 5 bước chạy kiểm định Hausman trên Stata, cách đọc chi2 và Prob > chi2, cách xử lý khi gặp lỗi ma trận không xác định dương, và những kiểm định cần làm tiếp sau khi chọn mô hình.
Dữ liệu bảng và ba mô hình cơ bản
Dữ liệu bảng kết hợp chiều không gian (nhiều đơn vị i: doanh nghiệp, ngân hàng, tỉnh) và chiều thời gian (nhiều năm t). Ví dụ: 120 doanh nghiệp niêm yết trên HOSE trong giai đoạn 2015 - 2025 tạo thành bảng 1.320 quan sát. Ba mô hình ước lượng cơ bản gồm:
- Pooled OLS: gộp toàn bộ dữ liệu, bỏ qua đặc điểm riêng của từng đơn vị. Đơn giản nhưng thường bị chệch nếu có khác biệt không quan sát được giữa các doanh nghiệp.
- Mô hình tác động cố định (FEM): cho phép mỗi đơn vị có hệ số chặn riêng, kiểm soát mọi đặc điểm không đổi theo thời gian (văn hóa doanh nghiệp, năng lực quản trị) kể cả khi các đặc điểm này tương quan với biến độc lập.
- Mô hình tác động ngẫu nhiên (REM): coi khác biệt giữa các đơn vị là ngẫu nhiên và không tương quan với biến độc lập. Hiệu quả hơn FEM khi giả định này đúng, và ước lượng được tác động của biến không đổi theo thời gian.
Mô hình tổng quát: yit = β0 + β1·xit + ui + εit, trong đó ui là tác động riêng không quan sát được của đơn vị i. Câu hỏi then chốt: ui có tương quan với xit hay không. Đó chính là điều kiểm định Hausman trả lời.
Hiểu trực giác về FEM và REM
Hãy hình dung bạn nghiên cứu tác động của đòn bẩy tài chính đến lợi nhuận. Mỗi doanh nghiệp có những đặc điểm khó đo lường như chất lượng ban điều hành, mối quan hệ với ngân hàng hay uy tín thương hiệu. Những đặc điểm này gần như không đổi trong vài năm và có thể ảnh hưởng đồng thời đến cả đòn bẩy lẫn lợi nhuận.
FEM xử lý vấn đề bằng cách chỉ sử dụng biến động bên trong từng doanh nghiệp qua thời gian (within variation). Câu hỏi FEM trả lời là: khi một doanh nghiệp tăng đòn bẩy so với mức trung bình của chính nó, lợi nhuận của doanh nghiệp đó thay đổi thế nào. Mọi đặc điểm không đổi đã bị loại bỏ khỏi phép so sánh.
REM sử dụng cả biến động bên trong và biến động giữa các doanh nghiệp (between variation), nên ước lượng chính xác hơn với sai số chuẩn nhỏ hơn. Đổi lại, nếu các đặc điểm không quan sát được có liên quan đến đòn bẩy, phần biến động giữa doanh nghiệp sẽ làm hệ số bị chệch.
Vì vậy, lựa chọn mô hình không chỉ là câu chuyện thống kê. Bạn nên lập luận về bản chất của dữ liệu: các đơn vị là toàn bộ tổng thể (ví dụ 63 tỉnh thành) thường nghiêng về FEM; các đơn vị là mẫu ngẫu nhiên từ tổng thể lớn (hộ gia đình trong khảo sát VHLSS) thường phù hợp với REM hơn nếu giả định không tương quan hợp lý.
Kiểm định Hausman là gì?
Kiểm định Hausman do Jerry Hausman đề xuất năm 1978, so sánh hai bộ hệ số: một bộ luôn nhất quán (FEM) và một bộ hiệu quả hơn nhưng chỉ nhất quán khi giả định đúng (REM). Nếu hai bộ hệ số khác nhau một cách có hệ thống, giả định của REM bị vi phạm.
- H0: khác biệt giữa hệ số FEM và REM không mang tính hệ thống (ui không tương quan với biến độc lập), nên chọn REM.
- H1: khác biệt mang tính hệ thống, nên chọn FEM.
Thống kê kiểm định Hausman có phân phối Chi bình phương với bậc tự do bằng số hệ số được so sánh. Quy tắc quyết định: Prob > chi2 nhỏ hơn 0,05 thì bác bỏ H0 và chọn FEM; ngược lại chọn REM.
Quy trình chọn mô hình dữ liệu bảng
Trong thực hành, kiểm định Hausman thường nằm trong một chuỗi ba kiểm định:
| So sánh | Kiểm định | Lệnh Stata | Kết luận khi p < 0,05 |
|---|---|---|---|
| Pooled OLS và FEM | F test (tất cả u_i = 0) | Có sẵn dưới bảng xtreg, fe | Chọn FEM |
| Pooled OLS và REM | Breusch-Pagan LM | xttest0 | Chọn REM |
| FEM và REM | Kiểm định Hausman | hausman fe re | Chọn FEM |
Nếu cả F test và Breusch-Pagan đều cho thấy Pooled OLS không phù hợp, kiểm định Hausman là bước phân xử cuối cùng giữa FEM và REM.
5 bước kiểm định Hausman trên Stata
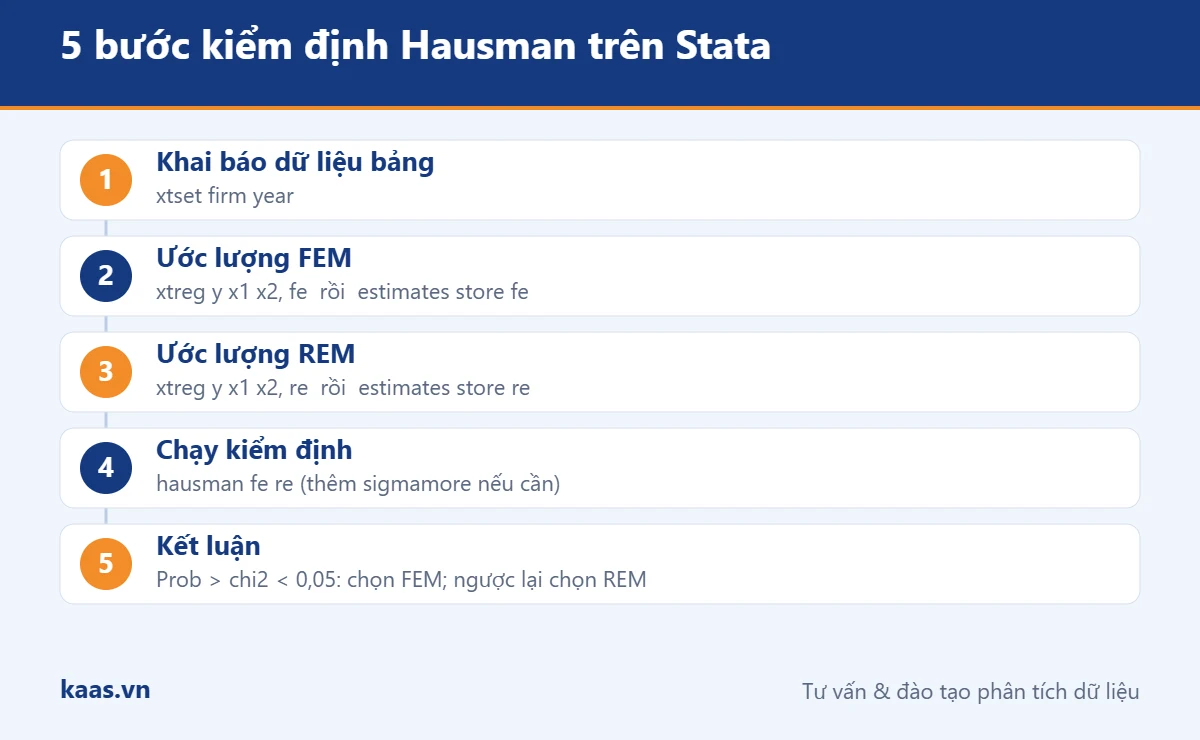
Bước 1: Khai báo dữ liệu bảng
Dữ liệu cần ở dạng long: mỗi dòng là một đơn vị tại một năm. Biến định danh đơn vị phải là biến số; nếu là chuỗi (mã chứng khoán), dùng encode:
encode ticker, gen(firm)
xtset firm year
xtdescribe
Lệnh xtdescribe cho biết bảng cân bằng hay không cân bằng và cấu trúc dữ liệu thiếu.
Bước 2: Ước lượng FEM và lưu kết quả
xtreg roa lev size growth liq, fe
estimates store fe
Dưới bảng kết quả, dòng "F test that all u_i=0" cho biết FEM có tốt hơn Pooled OLS không.
Bước 3: Ước lượng REM và lưu kết quả
xtreg roa lev size growth liq, re
estimates store re
xttest0
Lệnh xttest0 thực hiện kiểm định Breusch-Pagan LM so sánh REM với Pooled OLS.
Bước 4: Chạy kiểm định Hausman
hausman fe re
Thứ tự rất quan trọng: mô hình nhất quán (fe) đặt trước, mô hình hiệu quả (re) đặt sau. Đảo ngược thứ tự sẽ làm thống kê có dấu sai và kết luận sai.
Bước 5: Kết luận và kiểm tra tiếp
Đọc dòng Prob > chi2 để chọn mô hình, sau đó kiểm định các khuyết tật (phương sai sai số thay đổi, tự tương quan) trên mô hình đã chọn.
Cách đọc kết quả kiểm định Hausman
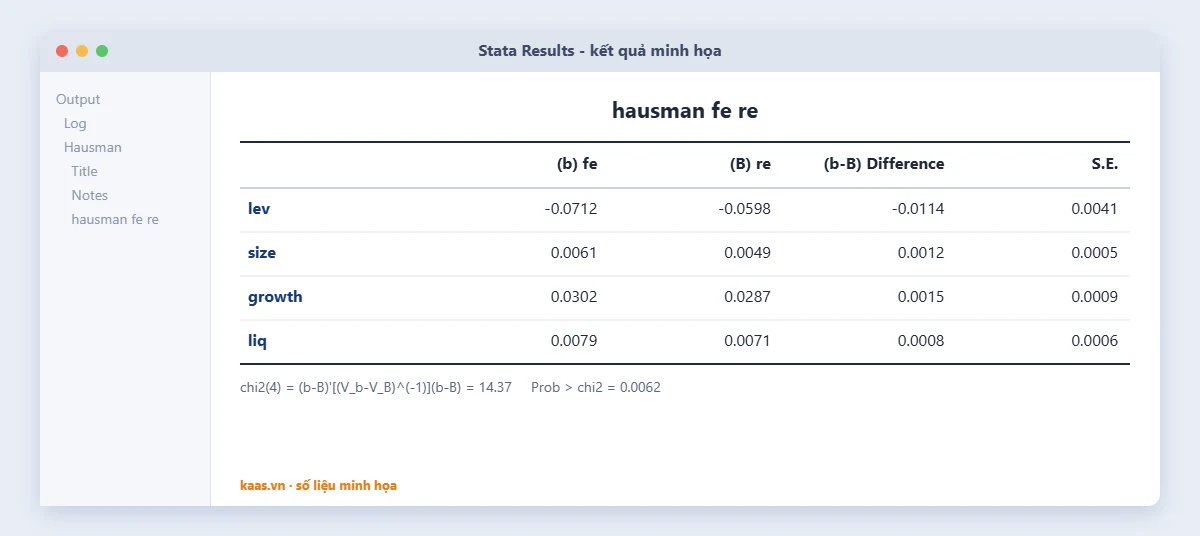
Bảng minh họa trên là kết quả kiểm định Hausman cho mô hình ROA của 120 doanh nghiệp, giai đoạn 2015 - 2025. Số liệu chỉ mang tính minh họa.
- Cột (b) fe và (B) re: hệ số của từng biến trong hai mô hình.
- Cột (b-B) Difference: chênh lệch hệ số. Biến lev có chênh lệch lớn nhất so với sai số chuẩn.
- Cột sqrt(diag(V_b-V_B)) S.E.: sai số chuẩn của chênh lệch.
- chi2(4) = 14,37; Prob > chi2 = 0,0062: nhỏ hơn 0,05, bác bỏ H0, chọn mô hình FEM.
Diễn giải: các đặc điểm riêng không quan sát được của doanh nghiệp có tương quan với các biến độc lập, nên REM cho ước lượng chệch. Mô hình FEM phù hợp hơn cho dữ liệu này.
Xử lý lỗi thường gặp khi kiểm định Hausman
Ma trận V_b - V_B không xác định dương
Stata có thể báo "V_b-V_B is not positive definite" hoặc chi2 âm. Nguyên nhân là hai ma trận phương sai được ước lượng với hai ước lượng sai số khác nhau. Cách xử lý:
hausman fe re, sigmamore
Tùy chọn sigmamore (hoặc sigmaless) buộc hai ma trận dùng chung một ước lượng phương sai, giúp thống kê ổn định hơn. Đây là cách làm được khuyến nghị trong tài liệu Stata.
Mô hình có sai số chuẩn vững
Kiểm định Hausman truyền thống không dùng được với tùy chọn vce(robust) hoặc vce(cluster). Khi cần sai số chuẩn vững, dùng kiểm định Sargan-Hansen thông qua lệnh cài thêm:
ssc install xtoverid
xtreg roa lev size growth liq, re vce(cluster firm)
xtoverid
Kết quả xtoverid có p < 0,05 thì chọn FEM, tương tự cách đọc kiểm định Hausman.
Biến không đổi theo thời gian
Biến như ngành nghề, năm thành lập bị loại khỏi FEM (omitted because of collinearity). Kiểm định Hausman chỉ so sánh các hệ số có mặt ở cả hai mô hình. Nếu biến không đổi theo thời gian là trọng tâm nghiên cứu, cân nhắc mô hình Hausman-Taylor (xthtaylor) hoặc cách tiếp cận Mundlak.
Kiểm định khuyết tật sau khi chọn mô hình
Kiểm định Hausman chỉ giúp chọn giữa FEM và REM, chưa đảm bảo mô hình không có khuyết tật. Các kiểm định cần làm tiếp:
| Khuyết tật | Kiểm định | Lệnh Stata |
|---|---|---|
| Phương sai sai số thay đổi (FEM) | Modified Wald | xttest3 (sau xtreg, fe) |
| Phương sai sai số thay đổi (REM) | Breusch-Pagan | xttest0 hoặc kiểm định LR |
| Tự tương quan bậc 1 | Wooldridge | xtserial roa lev size growth liq |
| Phụ thuộc chéo | Pesaran CD | xtcsd, pesaran abs |
| Đa cộng tuyến | VIF | reg ... rồi vif |
Khi phát hiện khuyết tật, các cách khắc phục phổ biến là sai số chuẩn cụm theo doanh nghiệp (vce(cluster firm)), sai số chuẩn Driscoll-Kraay (xtscc) khi có phụ thuộc chéo, hoặc ước lượng FGLS (xtgls) khi số năm đủ dài. Nếu có biến nội sinh, cần cân nhắc GMM (xtabond2).
Xem thêm các bước làm việc với Stata tại bài hỗ trợ chạy Stata.
Ví dụ thực hành với dữ liệu ngân hàng
Xét một đề tài về các yếu tố ảnh hưởng đến tỷ lệ nợ xấu của 27 ngân hàng thương mại Việt Nam giai đoạn 2012 - 2025 (số liệu minh họa, 378 quan sát). Biến phụ thuộc là tỷ lệ nợ xấu NPL; biến độc lập gồm tăng trưởng tín dụng, quy mô tổng tài sản (log), tỷ lệ vốn chủ sở hữu, tăng trưởng GDP và lạm phát.
F test dưới bảng FEM cho F(26, 346) = 9,14, p < 0,001, nghĩa là có khác biệt đáng kể giữa các ngân hàng. Breusch-Pagan LM cho chibar2 = 387,6, p < 0,001. Như vậy Pooled OLS không phù hợp.
So sánh FEM và REM cho chi2(5) = 8,21, Prob > chi2 = 0,145. Không bác bỏ H0, nên REM được lựa chọn. Kết quả này hợp lý vì hai biến vĩ mô (GDP, lạm phát) giống nhau giữa các ngân hàng trong cùng năm và không phụ thuộc đặc điểm riêng của từng ngân hàng.
Tiếp theo, kiểm định Wooldridge cho thấy có tự tương quan bậc 1 (p = 0,003). Mô hình REM được ước lượng lại với sai số chuẩn cụm theo ngân hàng. Với chỉ 27 cụm, tác giả ghi chú hạn chế và bổ sung sai số chuẩn Driscoll-Kraay để kiểm tra độ vững.
Ví dụ cho thấy quy trình chọn mô hình là một chuỗi quyết định có lý do, được ghi lại đầy đủ để người đọc có thể kiểm chứng.
Cách tiếp cận Mundlak
Mundlak (1978) đề xuất thêm vào REM giá trị trung bình theo đơn vị của các biến thay đổi theo thời gian. Nếu các biến trung bình này có ý nghĩa chung (kiểm định bằng lệnh test), giả định của REM bị vi phạm. Cách làm này cho kết luận tương đương kiểm định truyền thống nhưng cho phép dùng sai số chuẩn vững và giữ lại biến không đổi theo thời gian:
foreach v of varlist lev size growth liq {
  bysort firm: egen m_`v' = mean(`v')
}
xtreg roa lev size growth liq m_*, re vce(cluster firm)
test m_lev m_size m_growth m_liq
Những lỗi phương pháp cần tránh
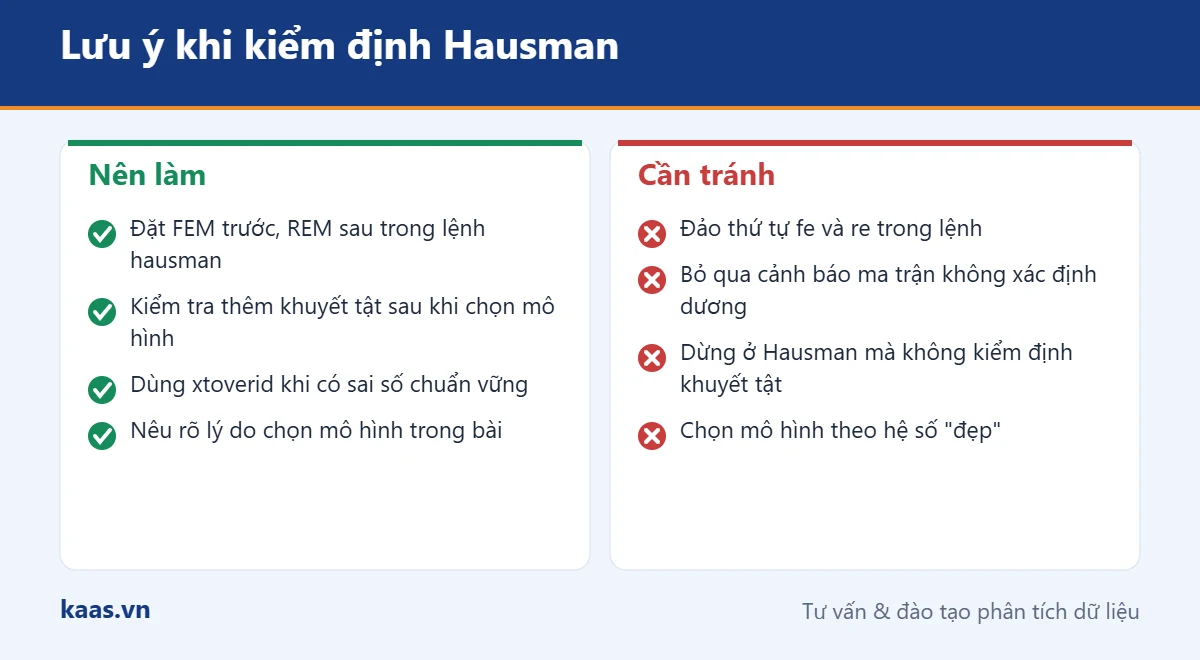
- Đảo thứ tự fe và re trong lệnh hausman, dẫn đến kết luận ngược.
- Bỏ qua cảnh báo ma trận không xác định dương và vẫn đọc Prob > chi2 như bình thường.
- Dừng lại ở kiểm định Hausman mà không kiểm định và khắc phục khuyết tật.
- Chọn mô hình theo hệ số "đẹp": báo cáo REM vì có nhiều biến có ý nghĩa hơn, trái với kết quả kiểm định.
- Áp dụng máy móc với bảng có T rất ngắn và N nhỏ, nơi lực kiểm định thấp; nên kết hợp lập luận lý thuyết về bản chất của ui.
Cách trình bày kiểm định Hausman trong luận văn
Nên gộp các kiểm định lựa chọn mô hình vào một bảng:
| Kiểm định | Thống kê | p | Kết luận |
|---|---|---|---|
| F test (Pooled và FEM) | F(119, 1196) = 6,82 | 0,000 | FEM phù hợp hơn Pooled |
| Breusch-Pagan LM (Pooled và REM) | chibar2 = 912,4 | 0,000 | REM phù hợp hơn Pooled |
| Kiểm định Hausman (FEM và REM) | chi2(4) = 14,37 | 0,006 | Chọn FEM |
Ghi chú: số liệu minh họa. Ví dụ diễn giải: "Kết quả kiểm định Hausman cho thấy Prob > chi2 = 0,006 < 0,05, do đó bác bỏ giả thuyết H0 và mô hình tác động cố định được lựa chọn."
Checklist trước khi nộp kết quả kiểm định Hausman
- Đã khai báo đúng xtset với biến đơn vị và biến thời gian.
- Đã chạy đủ ba kiểm định F test, Breusch-Pagan và kiểm định Hausman.
- Lệnh hausman đặt fe trước, re sau; dùng sigmamore khi cần.
- Đã kiểm định phương sai sai số thay đổi, tự tương quan và phụ thuộc chéo.
- Mô hình cuối cùng có sai số chuẩn phù hợp với khuyết tật phát hiện.
- Lưu file do-file để tái lập toàn bộ kết quả.
Câu hỏi thường gặp về kiểm định Hausman
Prob > chi2 = 0,06 thì chọn mô hình nào?
Ở mức ý nghĩa 5%, chưa bác bỏ H0 nên chọn REM. Tuy nhiên, kết quả sát ngưỡng nên bạn có thể báo cáo cả hai mô hình như kiểm tra độ vững và thảo luận sự khác biệt.
Kiểm định Hausman có làm được trên Eviews không?
Có. Trong Eviews, ước lượng mô hình với Random effects, sau đó chọn View > Fixed/Random Effects Testing > Correlated Random Effects - Hausman Test.
Bảng không cân bằng có chạy kiểm định Hausman được không?
Được. Stata xử lý bảng không cân bằng bình thường, nhưng bạn nên báo cáo số đơn vị, số năm trung bình và lý do dữ liệu thiếu.
Có cần kiểm định Hausman nếu đã dùng GMM không?
Không. GMM là cách tiếp cận khác để xử lý nội sinh và biến trễ phụ thuộc; các kiểm định đi kèm là AR(2) và Hansen.
Cần hướng dẫn xử lý dữ liệu bảng trên Stata?
Kaas.vn hướng dẫn khai báo dữ liệu, chọn mô hình, kiểm định khuyết tật và giải thích kết quả; bạn nhận do-file để tự chạy lại. Xem hỗ trợ chạy Stata hoặc gọi 0947 971 630 (Zalo).
Tài liệu tham khảo
- Baltagi, B. H. (2021). Econometric Analysis of Panel Data (6th ed.). Springer.
- Hausman, J. A. (1978). Specification tests in econometrics. Econometrica, 46(6), 1251-1271. doi:10.2307/1913827
- Wooldridge, J. M. (2010). Econometric Analysis of Cross Section and Panel Data (2nd ed.). MIT Press.
- Hỗ trợ xử lý SPSS: 12 kỹ thuật phân tích và quy trình làm việc minh bạch
- Trắc lượng thư mục với VOSviewer: 7 bước từ tìm kiếm đến bản đồ tri thức
- Chạy Eview cho chuỗi thời gian: 8 bước từ kiểm định tính dừng đến ARDL, VECM
- Chạy định lượng là gì? Hướng dẫn 8 bước chạy định lượng cho luận văn
- Thống kê mô tả SPSS: 7 bước chạy và đọc kết quả trung bình, độ lệch chuẩn

