

Phân tích CFA (Confirmatory Factor Analysis, phân tích nhân tố khẳng định) là bước kiểm định thang đo bắt buộc trước khi chạy mô hình cấu trúc SEM. Nếu EFA giúp bạn khám phá cấu trúc nhân tố, thì phân tích CFA kiểm tra xem cấu trúc đã đề xuất từ lý thuyết có phù hợp với dữ liệu thực tế hay không. Bài viết hướng dẫn 6 bước phân tích CFA trên AMOS, cách đọc các chỉ số độ phù hợp mô hình, hệ số tải, độ tin cậy tổng hợp CR, phương sai trích AVE, giá trị phân biệt và cách hiệu chỉnh mô hình đúng chuẩn học thuật.
Phân tích CFA là gì?
Phân tích CFA là kỹ thuật thuộc họ mô hình phương trình cấu trúc (SEM), dùng để kiểm định mô hình đo lường: mỗi biến quan sát được giả định đo một biến tiềm ẩn cụ thể, và các biến tiềm ẩn có thể tương quan với nhau. Khác với EFA, nhà nghiên cứu xác định trước biến quan sát nào thuộc nhân tố nào dựa trên lý thuyết và thang đo gốc.
Kết quả phân tích CFA trả lời bốn câu hỏi:
- Mô hình đo lường có phù hợp với dữ liệu không (model fit)?
- Các biến quan sát có đo tốt khái niệm của mình không (hệ số tải, giá trị hội tụ)?
- Thang đo có đáng tin cậy không (CR)?
- Các khái niệm có thực sự khác biệt nhau không (giá trị phân biệt)?
Phần mềm phổ biến cho phân tích CFA ở Việt Nam là IBM SPSS AMOS, ngoài ra có thể dùng gói lavaan trong R, Mplus hoặc Stata (lệnh sem).
Phân tích CFA khác gì EFA?
| Tiêu chí | EFA | Phân tích CFA |
|---|---|---|
| Mục đích | Khám phá cấu trúc nhân tố | Khẳng định cấu trúc đã đề xuất |
| Cơ sở | Dữ liệu dẫn dắt | Lý thuyết dẫn dắt |
| Biến quan sát | Có thể tải lên mọi nhân tố | Chỉ tải lên nhân tố đã chỉ định |
| Phần mềm | SPSS | AMOS, R lavaan, Mplus |
| Chỉ số chính | KMO, Bartlett, hệ số tải, phương sai trích | CMIN/DF, CFI, TLI, RMSEA, CR, AVE |
Trong luận văn, quy trình phổ biến là: Cronbach's Alpha, EFA, phân tích CFA, rồi SEM. Một số tác giả khuyến nghị dùng hai mẫu khác nhau cho EFA và CFA để tránh "khẳng định" chính cấu trúc vừa khám phá trên cùng dữ liệu.
Điều kiện trước khi phân tích CFA
- Cỡ mẫu: nhiều tài liệu khuyến nghị từ 200 quan sát trở lên; Hair và cộng sự (2019) gợi ý cỡ mẫu phụ thuộc số nhân tố, số biến quan sát mỗi nhân tố và độ lớn hệ số tải. Xem cách tính cỡ mẫu.
- Dữ liệu sạch: không có giá trị thiếu (AMOS mặc định yêu cầu dữ liệu đầy đủ để tính modification indices), đã xử lý ngoại lai.
- Phân phối: phương pháp ước lượng mặc định Maximum Likelihood giả định phân phối chuẩn đa biến. Khi vi phạm nặng, cân nhắc bootstrap Bollen-Stine hoặc ước lượng vững.
- Mỗi nhân tố tối thiểu 3 biến quan sát để mô hình xác định được (identified).
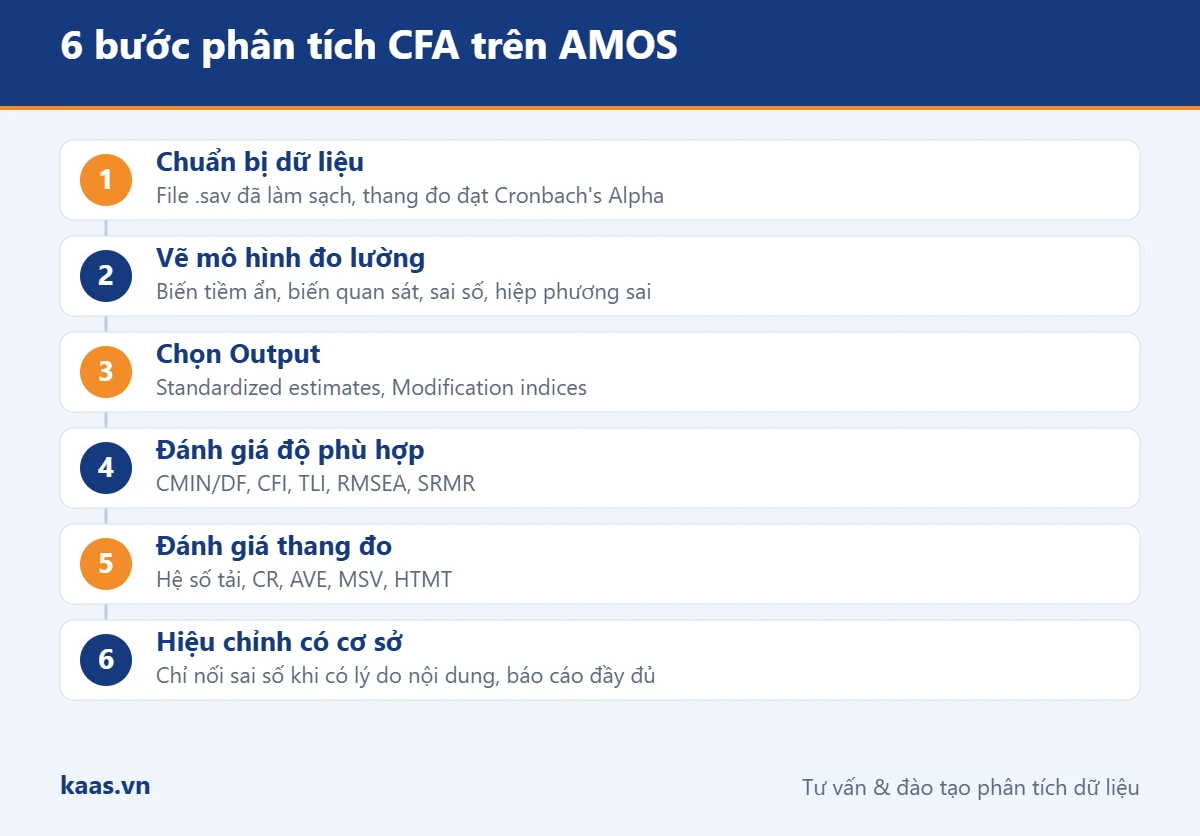
6 bước phân tích CFA trên AMOS
Bước 1: Chuẩn bị dữ liệu
Dùng file .sav đã làm sạch, các thang đo đã đạt Cronbach's Alpha và EFA. Đặt tên biến ngắn, không dấu, không khoảng trắng, vì AMOS sẽ dùng tên biến để hiển thị trên sơ đồ.
Bước 2: Vẽ mô hình đo lường
Mở AMOS Graphics, vào File > Data Files chọn file dữ liệu. Dùng công cụ Draw a latent variable or add an indicator để vẽ từng biến tiềm ẩn kèm số biến quan sát tương ứng. Kéo biến quan sát từ List variables in data set vào các ô chữ nhật. Đặt tên biến tiềm ẩn và sai số (có thể dùng Plugins > Name Unobserved Variables).
Tiếp theo, vẽ mũi tên hai chiều (hiệp phương sai) giữa tất cả các cặp biến tiềm ẩn. Plugin Draw Covariances giúp làm việc này nhanh khi chọn tất cả biến tiềm ẩn.
Bước 3: Chọn Output
Vào View > Analysis Properties > Output, tick Standardized estimates, Squared multiple correlations và Modification indices (ngưỡng mặc định 4). Nếu cần kiểm tra phân phối, tick thêm Tests for normality and outliers. Nhấn Calculate Estimates để chạy phân tích CFA.
Bước 4: Đánh giá độ phù hợp mô hình
Mở View Text > Model Fit để đọc các chỉ số. Phần tiếp theo giải thích chi tiết từng chỉ số.
Bước 5: Đánh giá thang đo
Xem bảng Standardized Regression Weights (hệ số tải chuẩn hóa) và tính CR, AVE, MSV. Plugin Validity and Reliability Test hoặc file Excel tính toán của Gaskin giúp tính nhanh.
Bước 6: Hiệu chỉnh mô hình có cơ sở
Nếu mô hình chưa phù hợp, xem xét loại biến quan sát có hệ số tải thấp hoặc nối sai số theo Modification Indices, nhưng chỉ khi có lý do về nội dung. Mọi điều chỉnh phải được báo cáo đầy đủ.
Cách đọc chỉ số độ phù hợp trong phân tích CFA
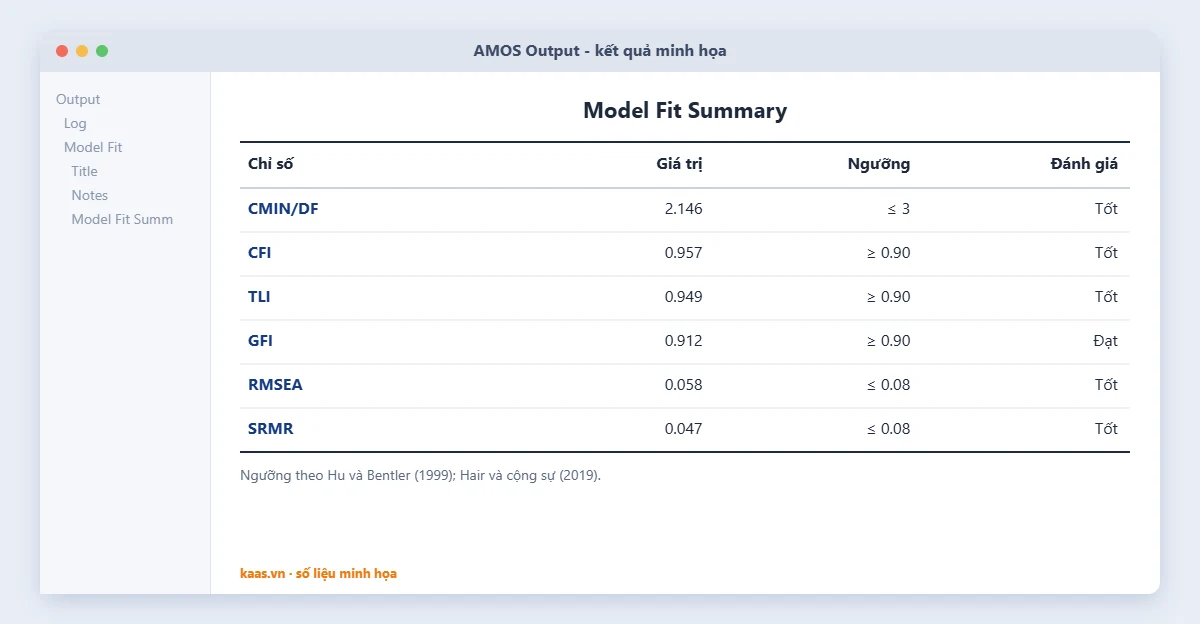
Bảng trên tổng hợp kết quả phân tích CFA minh họa cho mô hình 5 nhân tố, 22 biến quan sát, cỡ mẫu 350. Số liệu chỉ mang tính minh họa.
Chi-square và CMIN/DF
Kiểm định Chi-square (CMIN) đánh giá sự khác biệt giữa ma trận hiệp phương sai của mô hình và của dữ liệu. Với cỡ mẫu lớn, Chi-square gần như luôn có ý nghĩa, nên người ta dùng tỷ số CMIN/DF: nhỏ hơn 3 là tốt, nhỏ hơn 5 là chấp nhận được.
CFI và TLI
Đây là các chỉ số phù hợp gia tăng, so sánh mô hình của bạn với mô hình độc lập. CFI và TLI từ 0,90 là chấp nhận được, từ 0,95 là tốt (Hu và Bentler, 1999).
RMSEA và SRMR
RMSEA đo sai số xấp xỉ trên mỗi bậc tự do: dưới 0,06 là tốt, dưới 0,08 là chấp nhận được. SRMR là trung bình phần dư chuẩn hóa: dưới 0,08 là tốt. Trong AMOS, SRMR được tính qua Plugins > Standardized RMR và phải chạy lại mô hình khi cửa sổ plugin đang mở.
GFI và AGFI
GFI nhạy với cỡ mẫu và hiện nay ít được khuyến nghị làm tiêu chí chính. Nếu báo cáo, GFI từ 0,90 là tốt; một số tài liệu chấp nhận từ 0,80.
| Chỉ số | Ngưỡng chấp nhận | Ngưỡng tốt |
|---|---|---|
| CMIN/DF | < 5 | < 3 |
| CFI, TLI | ≥ 0,90 | ≥ 0,95 |
| RMSEA | < 0,08 | < 0,06 |
| SRMR | < 0,10 | < 0,08 |
| PCLOSE | > 0,01 | > 0,05 |
Không nên chọn lọc chỉ số "đạt" để báo cáo. Một báo cáo phân tích CFA minh bạch thường gồm Chi-square, df, p, CMIN/DF, CFI, TLI, RMSEA (kèm khoảng tin cậy 90%) và SRMR.
Đánh giá độ tin cậy và giá trị hội tụ
Hệ số tải chuẩn hóa
Hệ số tải chuẩn hóa từ 0,7 là lý tưởng; từ 0,5 là chấp nhận được khi các tiêu chí khác đạt. Biến có hệ số tải dưới 0,5 nên được xem xét loại bỏ, nhưng cần cân nhắc ý nghĩa nội dung của biến đó đối với khái niệm.
Độ tin cậy tổng hợp CR
CR (Composite Reliability) khắc phục hạn chế của Cronbach's Alpha khi các hệ số tải không bằng nhau. CR từ 0,7 là đạt yêu cầu.
Phương sai trích trung bình AVE
AVE (Average Variance Extracted) là trung bình bình phương hệ số tải chuẩn hóa. AVE từ 0,5 cho thấy nhân tố giải thích được hơn một nửa biến thiên của các biến quan sát, đạt giá trị hội tụ (Fornell và Larcker, 1981).
Đánh giá giá trị phân biệt trong phân tích CFA
Giá trị phân biệt cho biết các khái niệm có thực sự khác nhau. Có ba cách phổ biến:
- Fornell-Larcker: căn bậc hai AVE của mỗi nhân tố lớn hơn tương quan của nhân tố đó với các nhân tố khác.
- MSV < AVE: phương sai chia sẻ lớn nhất nhỏ hơn phương sai trích.
- HTMT: tỷ số dị biệt - đơn biệt nhỏ hơn 0,85 hoặc 0,90; đây là tiêu chí được khuyến nghị nhiều nhất hiện nay. Xem chi tiết tại bài HTMT.
| Nhân tố | CR | AVE | MSV | Đánh giá |
|---|---|---|---|---|
| Chất lượng dịch vụ | 0,891 | 0,622 | 0,318 | Đạt |
| Giá trị cảm nhận | 0,864 | 0,615 | 0,374 | Đạt |
| Niềm tin | 0,842 | 0,573 | 0,374 | Đạt |
| Sự hài lòng | 0,877 | 0,641 | 0,352 | Đạt |
| Ý định quay lại | 0,853 | 0,660 | 0,352 | Đạt |
Ghi chú: số liệu minh họa.
Hiệu chỉnh mô hình khi phân tích CFA chưa đạt
Loại biến quan sát có hệ số tải thấp
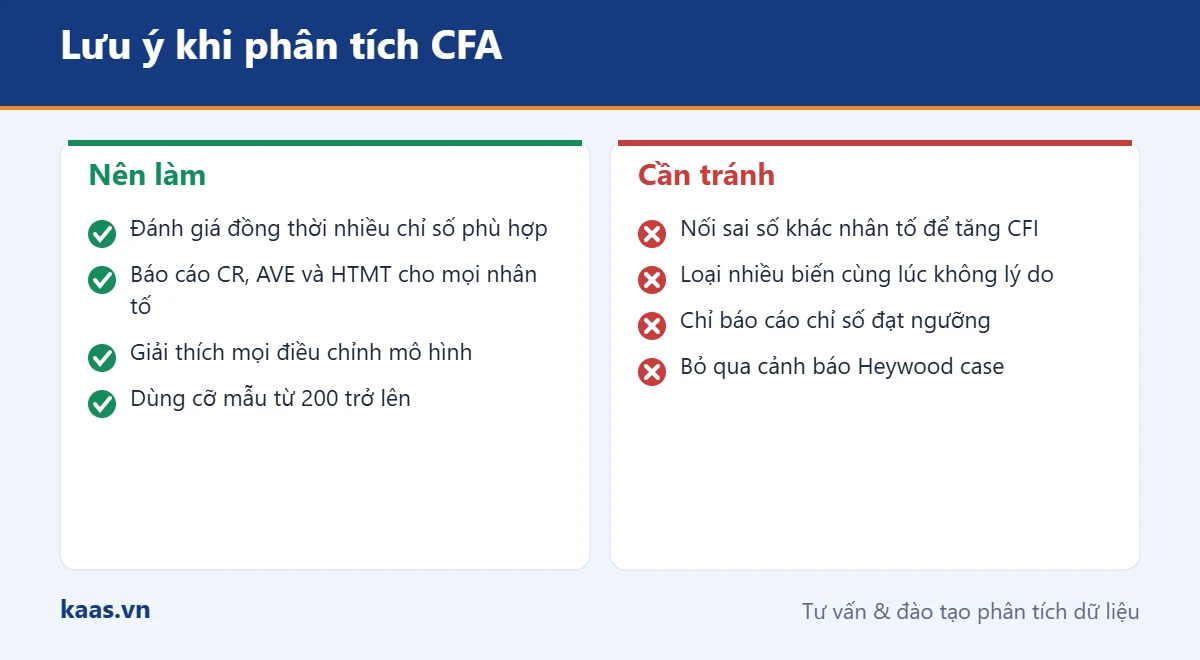
Loại từng biến một, bắt đầu từ biến có hệ số tải thấp nhất, rồi chạy lại. Không loại nhiều biến cùng lúc vì hệ số tải của các biến còn lại sẽ thay đổi. Mỗi nhân tố nên còn tối thiểu 3 biến.
Nối sai số theo Modification Indices
Modification Indices (MI) gợi ý các tham số nếu được thêm vào sẽ giảm Chi-square. Chỉ nên nối sai số giữa các biến quan sát cùng một nhân tố khi hai câu hỏi có nội dung hoặc cách diễn đạt tương tự. Nối sai số giữa các nhân tố khác nhau để "kéo" chỉ số phù hợp là cách làm bị phản biện nặng.
Xử lý Heywood case
Khi hệ số tải chuẩn hóa lớn hơn 1 hoặc phương sai sai số âm, mô hình gặp Heywood case. Nguyên nhân thường là cỡ mẫu nhỏ, nhân tố chỉ có hai biến hoặc mô hình sai. Cần xem lại cấu trúc thay vì cố định phương sai bằng số nhỏ mà không giải thích.
Mô hình CFA bậc hai
Khi lý thuyết cho rằng các nhân tố bậc một cùng phản ánh một khái niệm bậc cao (ví dụ năm thành phần của chất lượng dịch vụ SERVQUAL), bạn có thể xây dựng phân tích CFA bậc hai. Cần có tối thiểu ba nhân tố bậc một và cơ sở lý thuyết rõ ràng.
Kiểm tra sai lệch phương pháp chung (CMB)
Khi tất cả biến được đo bằng một bảng hỏi tại một thời điểm, nguy cơ sai lệch phương pháp chung cần được đánh giá. Trong khuôn khổ phân tích CFA, có thể dùng kiểm định Harman một nhân tố (chỉ mang tính sơ bộ) hoặc thêm nhân tố phương pháp chung (common latent factor) và so sánh hệ số tải. Podsakoff và cộng sự (2003) là tài liệu tham khảo kinh điển về chủ đề này.
Cách trình bày kết quả phân tích CFA trong luận văn
- Mô tả mô hình đo lường: số nhân tố, số biến quan sát, phương pháp ước lượng.
- Báo cáo chỉ số phù hợp lần đầu và sau hiệu chỉnh (nếu có), kèm lý do từng điều chỉnh.
- Bảng hệ số tải chuẩn hóa, CR, AVE cho từng nhân tố.
- Bảng giá trị phân biệt (Fornell-Larcker và/hoặc HTMT).
- Sơ đồ phân tích CFA đã chuẩn hóa (chụp từ AMOS, đảm bảo đọc được).
Ví dụ viết: "Kết quả phân tích CFA cho thấy mô hình đo lường phù hợp với dữ liệu: χ²/df = 2,15; CFI = 0,957; TLI = 0,949; RMSEA = 0,058; SRMR = 0,047. Tất cả hệ số tải chuẩn hóa nằm trong khoảng 0,68 đến 0,87 (p < 0,001)."
Phân tích CFA bằng R với gói lavaan
Nếu không có bản quyền AMOS, bạn có thể thực hiện phân tích CFA miễn phí bằng R. Gói lavaan có cú pháp gần với cách viết mô hình trên giấy, giúp việc tái lập kết quả dễ dàng hơn.
library(lavaan)
mo_hinh <- '
  CL =~ CL1 + CL2 + CL3 + CL4 + CL5
  GT =~ GT1 + GT2 + GT3 + GT4
  NT =~ NT1 + NT2 + NT3 + NT4
  HL =~ HL1 + HL2 + HL3 + HL4
  YD =~ YD1 + YD2 + YD3
'
fit <- cfa(mo_hinh, data = du_lieu, estimator = "MLR")
summary(fit, fit.measures = TRUE, standardized = TRUE)
semTools::reliability(fit)
semTools::htmt(mo_hinh, data = du_lieu)
Ký hiệu =~ nghĩa là "được đo bởi". Tùy chọn estimator = "MLR" cho sai số chuẩn và chỉ số phù hợp vững khi dữ liệu không chuẩn. Hàm reliability của gói semTools trả về CR và AVE, còn htmt trả về ma trận HTMT.
Kết quả phân tích CFA giữa AMOS và lavaan thường gần như trùng khớp khi cùng dùng ước lượng ML. Khác biệt nhỏ có thể đến từ cách xử lý giá trị thiếu và cách tính bậc tự do.
Ví dụ quy trình phân tích CFA cho một luận văn
Giả sử một đề tài về ý định quay lại của khách du lịch có 5 nhân tố và 22 biến quan sát, cỡ mẫu 350 (số liệu minh họa). Lần chạy đầu cho CFI = 0,921, RMSEA = 0,069. Biến NT4 có hệ số tải 0,46.
Sau khi xem lại nội dung, NT4 là câu hỏi đảo nghĩa và nhiều người trả lời nhầm, nên được loại. Lần chạy thứ hai cho CFI = 0,957, RMSEA = 0,058. Hai sai số CL2 và CL3 có MI lớn, nhưng hai câu này đo hai khía cạnh khác nhau nên không nối.
Toàn bộ quá trình này được ghi trong luận văn, kèm bảng so sánh hai lần chạy. Cách báo cáo như vậy giúp hội đồng thấy rõ các quyết định phân tích là có cơ sở.
Checklist trước khi nộp kết quả phân tích CFA
- Cỡ mẫu phù hợp và dữ liệu không còn giá trị thiếu.
- Mỗi nhân tố có tối thiểu 3 biến quan sát.
- Báo cáo đầy đủ các chỉ số phù hợp, không chọn lọc.
- Hệ số tải, CR, AVE đạt ngưỡng hoặc có giải thích.
- Giá trị phân biệt được kiểm tra bằng HTMT.
- Mọi hiệu chỉnh trong phân tích CFA đều có lý do nội dung và được ghi lại.
Câu hỏi thường gặp về phân tích CFA
Có bắt buộc chạy EFA trước phân tích CFA không?
Không bắt buộc. Khi thang đo đã được kiểm định nhiều lần trong bối cảnh tương tự, có thể đi thẳng vào phân tích CFA. Khi thang đo được điều chỉnh hoặc dịch mới, EFA giúp phát hiện vấn đề sớm.
Mô hình có CFI = 0,88 có chấp nhận được không?
Dưới ngưỡng phổ biến 0,90. Bạn nên xem lại biến có hệ số tải thấp, phần dư chuẩn hóa lớn và cấu trúc mô hình trước khi kết luận. Nếu vẫn báo cáo, cần nêu rõ đây là hạn chế.
AMOS báo lỗi "model is probably unidentified" thì làm sao?
Kiểm tra mỗi biến tiềm ẩn đã cố định một hệ số tải bằng 1 hoặc cố định phương sai bằng 1, mỗi sai số đã có hệ số 1, và không có biến tiềm ẩn nào thiếu biến quan sát.
Phân tích CFA trên SmartPLS có được không?
SmartPLS dùng PLS-SEM, đánh giá mô hình đo lường bằng outer loading, CR, AVE, HTMT nhưng không có các chỉ số phù hợp như CFI. Xem bài phân tích SmartPLS để so sánh hai cách tiếp cận.
Cần hướng dẫn phân tích CFA và SEM trên AMOS?
Kaas.vn hướng dẫn vẽ mô hình, đọc chỉ số và hiệu chỉnh có cơ sở; bạn nhận file mô hình .amw để tự chạy lại. Xem dịch vụ AMOS hoặc gọi 0947 971 630 (Zalo).
Tài liệu tham khảo
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39-50.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate Data Analysis (8th ed.). Cengage.
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis. Structural Equation Modeling, 6(1), 1-55. doi:10.1080/10705519909540118
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research. Journal of Applied Psychology, 88(5), 879-903.
- Phân tích định lượng là gì? 9 phương pháp phổ biến và cách chọn đúng
- Tương quan Pearson SPSS: 5 bước chạy và cách đọc hệ số r chính xác
- Hỗ trợ chạy Stata: 6 bước phân tích dữ liệu bảng, hồi quy và kiểm định
- Thuật ngữ thống kê: 20 khái niệm cần biết khi làm nghiên cứu
- Thống kê mô tả SPSS: 7 bước chạy và đọc kết quả trung bình, độ lệch chuẩn

